Conectar estadística con modelos de redes en problemas reales: negocios en ciudad, relaciones de similitud, rutas, comunidades y recomendaciones; más un cierre con árboles de decisión y simulación por eventos.
🔧 Requisitos prácticos (Google Colab)
Instalar librerías con %pip (no !pip).
Separar celdas: instalar → importar → usar.
Guardar datasets en CSV para reproducibilidad.
Si no hay API Key, usar dataset simulado (incluido).
Teoría de redes (grafos) para estadística
Conceptos fundamentales
Un grafo se denota como \(G = (V, E)\), donde:
\(V\) es el conjunto de vértices o nodos.
\(E\) es el conjunto de aristas o enlaces que conectan pares de nodos.
Tipos de grafos
No dirigido: las aristas no tienen orientación, es decir, la conexión entre \(i\) y \(j\) es simétrica (\(i \leftrightarrow j\)).
Dirigido: las aristas tienen dirección, representando relaciones asimétricas (\(i \rightarrow j\)).
Peso de una arista
A cada conexión puede asociarse un peso\(w_{ij}\) que representa la intensidad, costo o similitud de la relación entre los nodos \(i\) y \(j\).
Matriz de adyacencia
El grafo puede representarse mediante una matriz de adyacencia\(A = [A_{ij}]\), donde:
\[
A_{ij} =
\begin{cases}
1, & \text{si existe una arista entre los nodos } i \text{ y } j, \\
0, & \text{en caso contrario.}
\end{cases}
\]
En grafos ponderados, \(A_{ij} = w_{ij}\).
Grado de un nodo
El grado de un nodo \(i\) en un grafo no dirigido se define como:
\[
k_i = \sum_j A_{ij}
\]
e indica el número de conexiones (o la suma de pesos, si el grafo es ponderado) asociadas al nodo \(i\).
Ejemplo
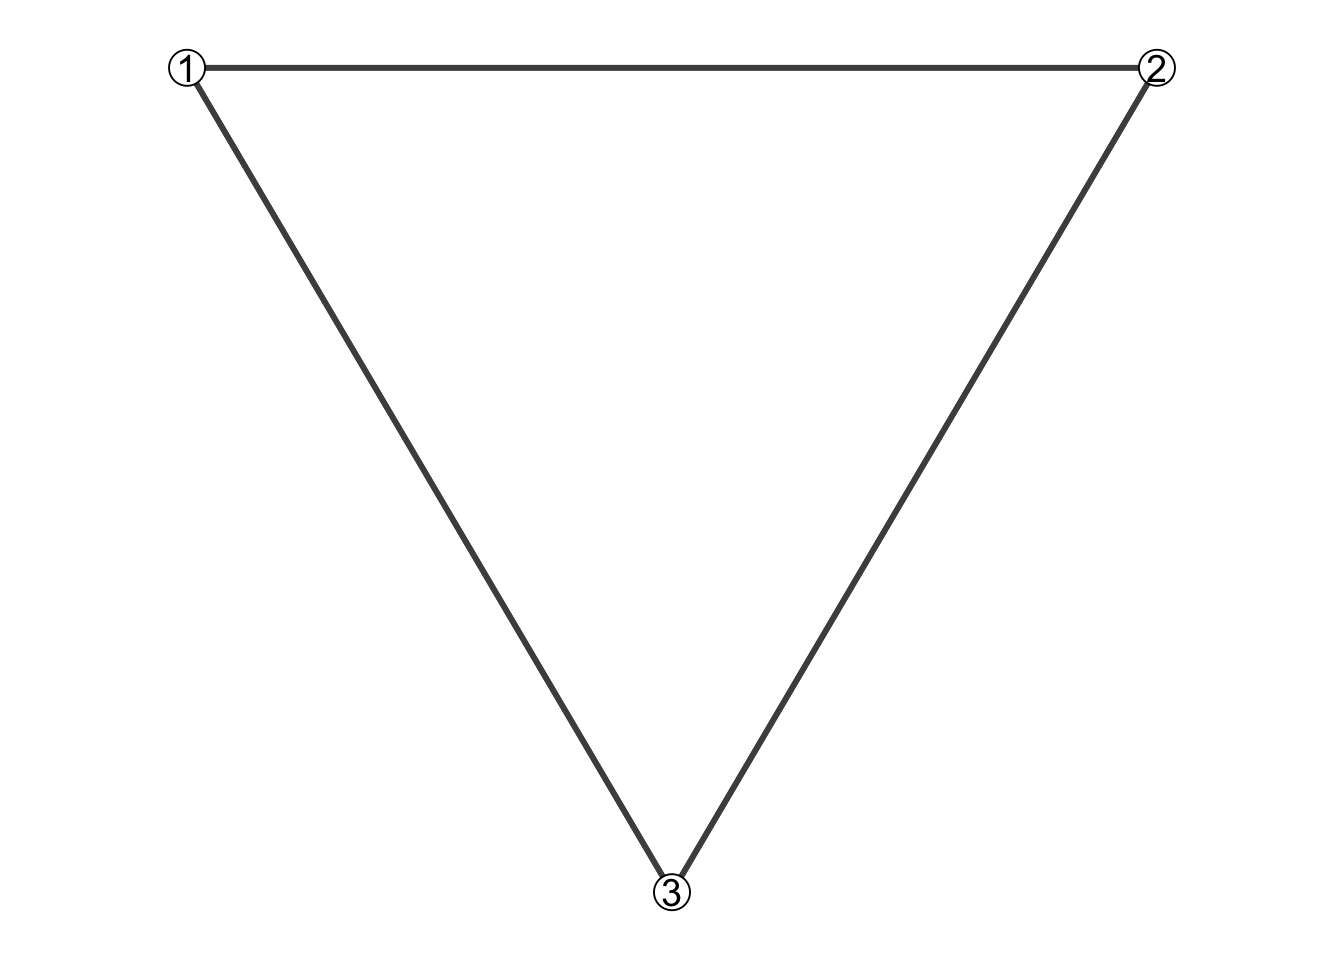
Considera el siguiente grafo no dirigido con tres nodos:
Este es un grafo completo con tres vértices (\(K_3\)).
Variables y redes
Una red es un modelo estructural; las variables (rating, reseñas, precio, barrio) son atributos de nodos.
La estadística describe y relaciona:
Distribuciones de atributos (p. ej., rating).
Distribuciones estructurales (p. ej., grados).
Correlaciones entre atributos y métricas de red.
Métricas clave
Las métricas permiten caracterizar la estructura y relevancia de los nodos dentro de un grafo. A continuación se presentan las más utilizadas en análisis de redes.
Densidad
La densidad mide la proporción de conexiones existentes frente a las posibles:
\[
\delta = \frac{2|E|}{|V|(|V|-1)}
\]
En un grafo no dirigido, \(\delta = 1\) indica un grafo completamente conectado (\(K_n\)).
Coeficiente de clustering
El coeficiente de clustering (o de agrupamiento) mide la tendencia de los vecinos de un nodo a estar también conectados entre sí.
Si \(T(i)\) es el número de triángulos que involucran al nodo \(i\), y \(k_i\) su grado:
\[
C_i = \frac{2T(i)}{k_i(k_i - 1)}
\]
El valor promedio \(C = \frac{1}{|V|}\sum_i C_i\) describe la cohesión local de la red.
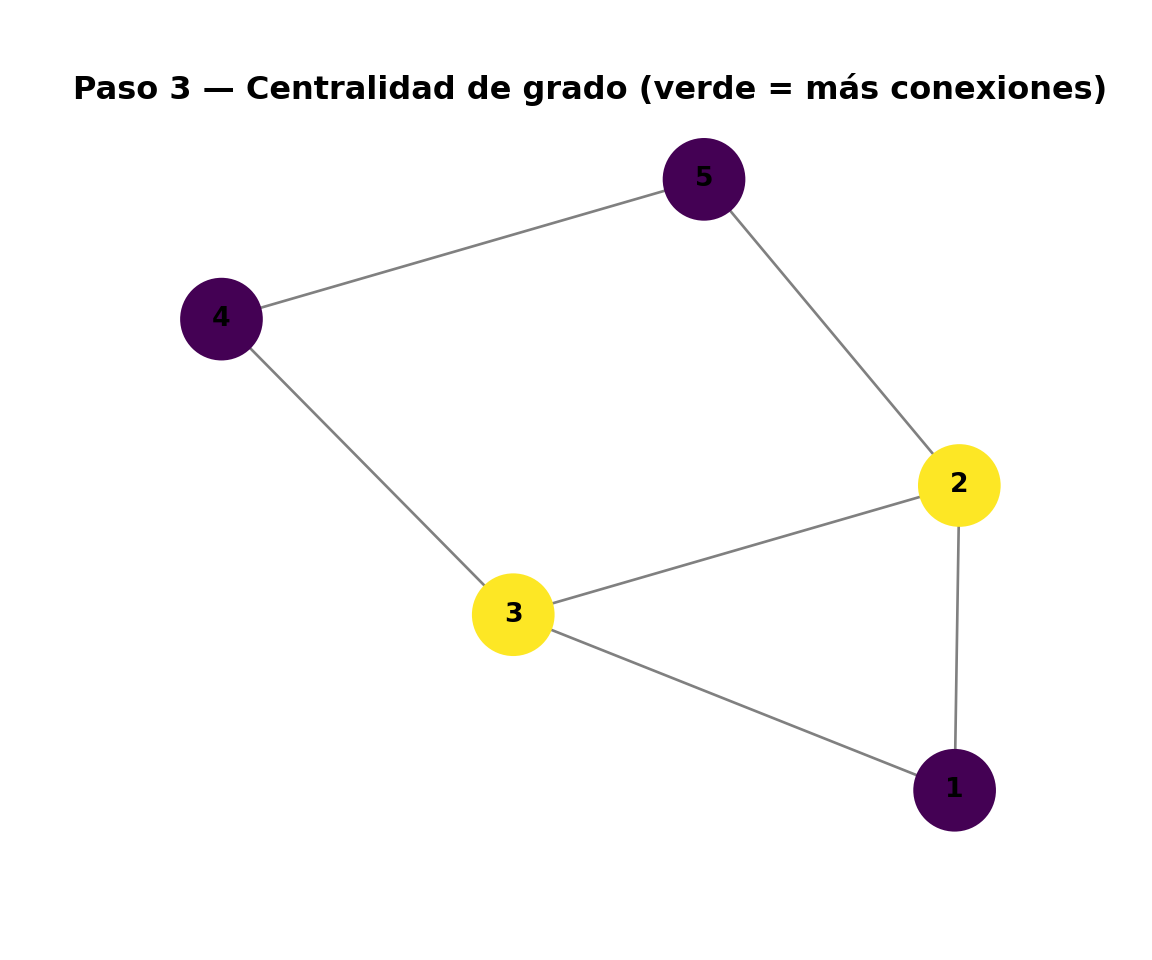
Centralidad de grado
La centralidad de grado mide la importancia de un nodo según su número de conexiones directas:
\[
C_D(i) = \frac{k_i}{|V| - 1}
\]
Un nodo con alto \(C_D(i)\) es un nodo altamente conectado (hub).
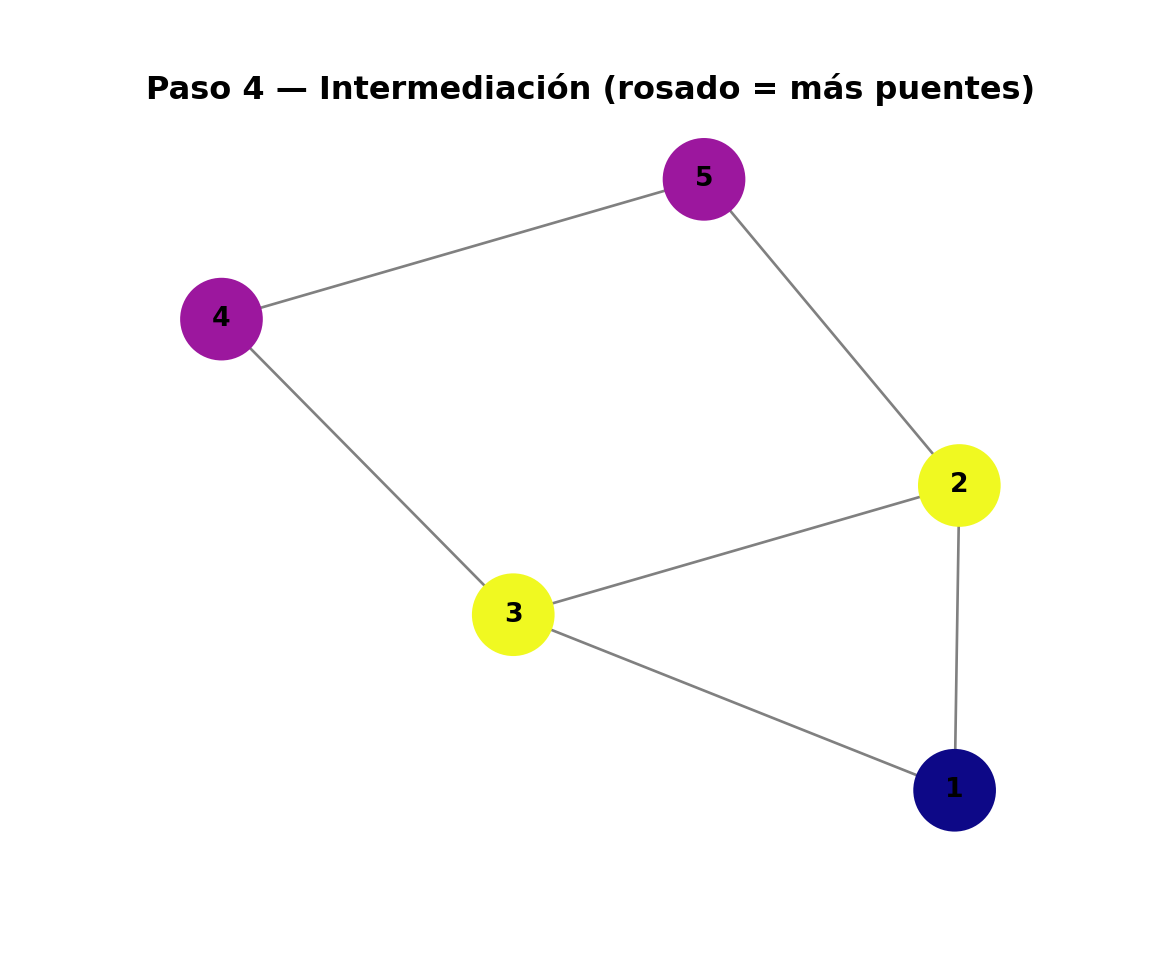
Centralidad de intermediación
La centralidad de intermediación (betweenness) cuantifica cuántas veces un nodo actúa como puente entre otros pares de nodos:
\[
C_B(i) = \sum_{s \neq i \neq t} \frac{\sigma_{st}(i)}{\sigma_{st}}
\]
donde \(\sigma_{st}\) es el número total de caminos más cortos entre \(s\) y \(t\),
y \(\sigma_{st}(i)\) es el número de esos caminos que pasan por \(i\).
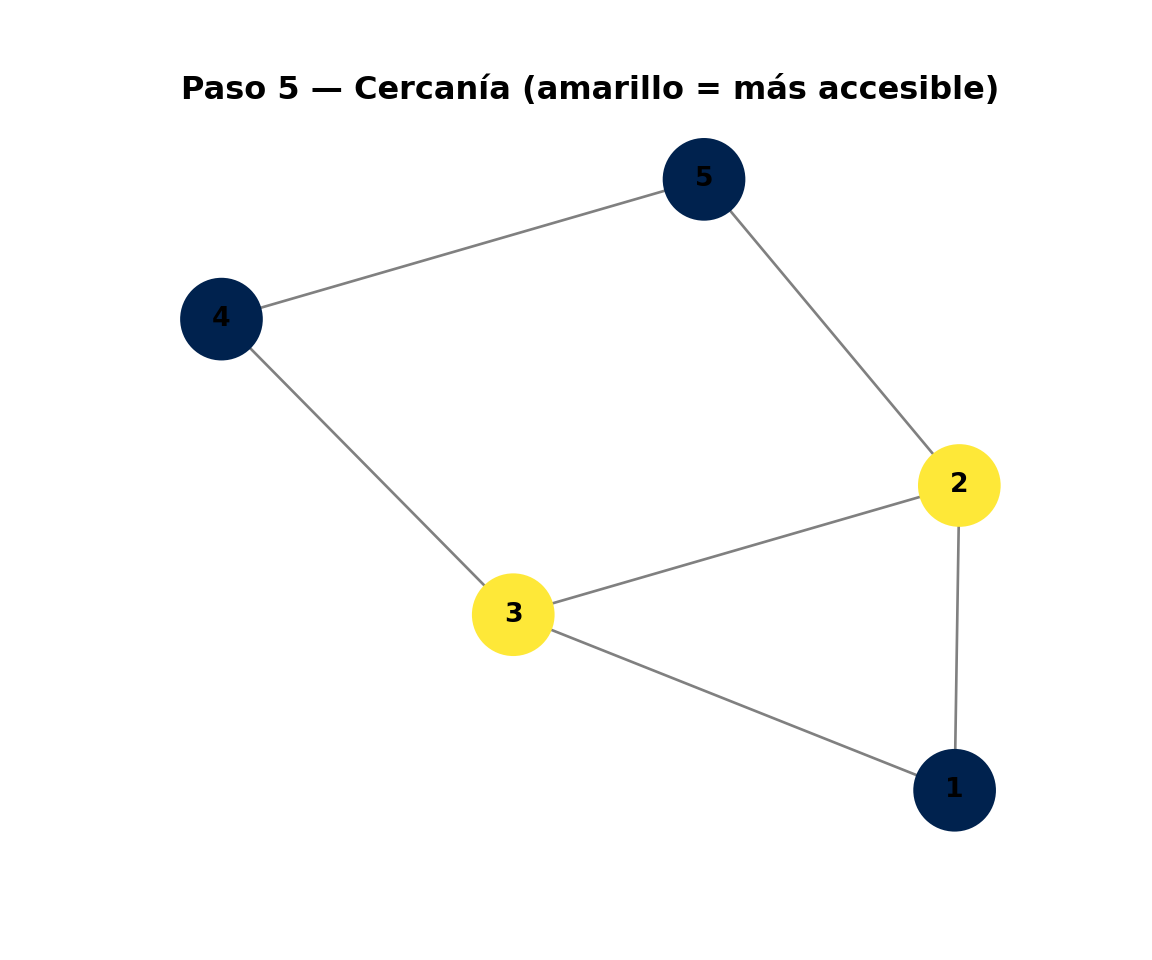
Centralidad de cercanía
La centralidad de cercanía mide qué tan próximo está un nodo, en promedio, al resto de la red:
\[
C_C(i) = \frac{1}{\sum_j d(i,j)}
\]
donde \(d(i,j)\) es la distancia geodésica (longitud del camino más corto) entre los nodos \(i\) y \(j\).
Un nodo con alto \(C_C(i)\) puede acceder rápidamente a los demás en la red.
Ejemplo
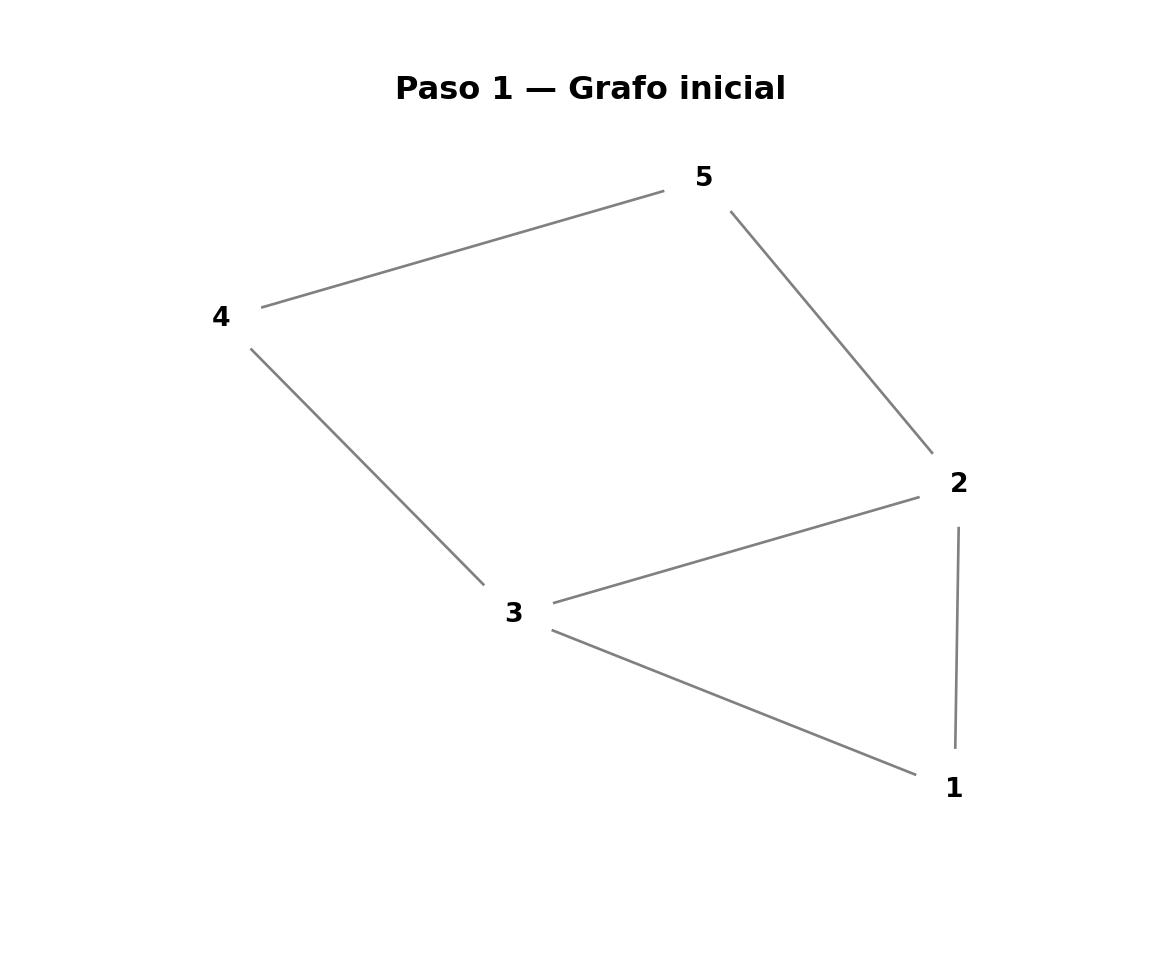
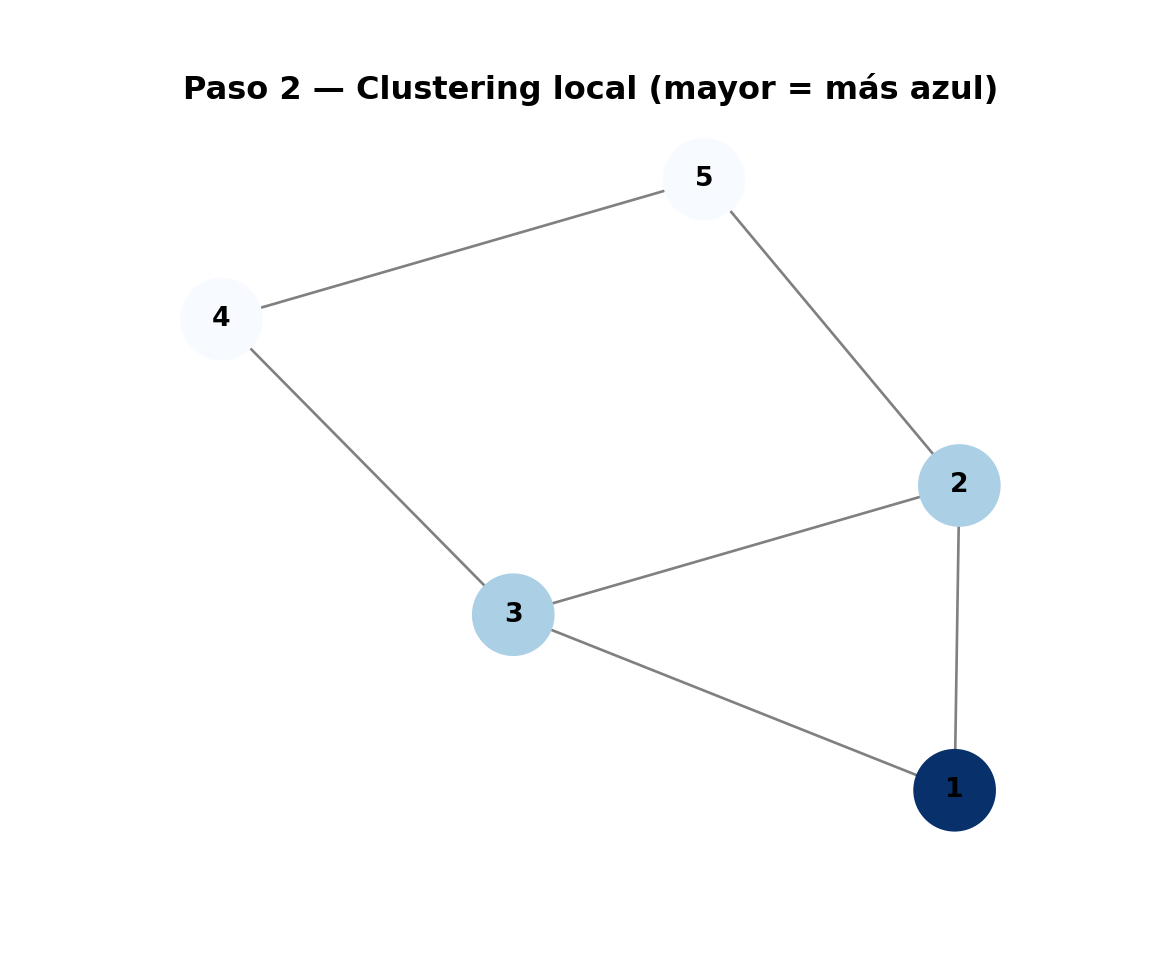
import networkx as nximport matplotlib.pyplot as pltfrom matplotlib import cm# 🎯 1. Construcción del grafoG = nx.Graph()edges = [(1, 2), (2, 3), (3, 4), (4, 5), (2, 5), (1, 3)]G.add_edges_from(edges)pos = nx.spring_layout(G, seed=42)# 🌈 Función auxiliar para graficar con estilodef dibujar_grafo(metrica, valores, titulo, cmap): plt.figure(figsize=(6, 5)) nx.draw_networkx( G, pos, with_labels=True, node_color=[valores[n] for n in G.nodes()], cmap=cmap, node_size=900, edge_color="gray", font_size=10, font_weight="bold" ) plt.title(titulo, fontsize=12, weight="bold") plt.axis("off") plt.show()# --- Paso 1. Grafo inicial ---dibujar_grafo(None, {n: 0.5for n in G.nodes()}, "Paso 1 — Grafo inicial", cm.Greys)
print("✅ Análisis completado — cada paso muestra visualmente la métrica principal.")
✅ Análisis completado — cada paso muestra visualmente la métrica principal.
Interpretación estadística
El análisis de redes puede entenderse desde una perspectiva estadística.
Cada métrica del grafo puede tratarse como una variable aleatoria con propiedades propias.
Distribución del grado
En una red real, el grado de los nodos, \(k_i\), puede interpretarse como una variable aleatoria que describe cuántas conexiones tiene un nodo típico.
\[
P(k) = \Pr(K = k)
\]
Esta distribución puede ser estrecha (homogénea) o de cola pesada (heterogénea), indicando la presencia de nodos altamente conectados (hubs).
Redes aleatorias vs. empíricas
Una red Erdős–Rényi (ER) es una referencia clásica: cada par de nodos se conecta con probabilidad \(p\). Su distribución de grado sigue aproximadamente una Binomial:
\[
P(k) = \binom{n-1}{k} p^k (1-p)^{n-1-k}
\]
En contraste, las redes empíricas (sociales, biológicas, de transporte) muestran colas más largas,
frecuentemente aproximadas por una Ley de Potencia:
\[
P(k) \propto k^{-\gamma}
\]
Sesgos de muestreo
En datos reales, pueden existir sesgos que alteran las métricas:
Datos faltantes: nodos o aristas no observadas.
Sesgo de popularidad: sobre-representación de nodos altamente conectados.
Estos sesgos afectan la estimación de \(P(k)\), de la modularidad y de las medidas de centralidad.
Comunidades y modularidad
Una comunidad es un grupo de nodos con alta densidad interna de conexiones y pocas externas.
La modularidad, denotada \(Q\), cuantifica la calidad de dicha partición:
Una red aleatoria de Erdős–Rényi, denotada como \(G(n, p)\), se construye a partir de un conjunto de \(n\) nodos donde cada par de nodos se conecta de manera independiente con probabilidad \(p\).
Matemáticamente:
\[
\Pr[(i,j) \in E] = p, \quad \text{para cada par } (i,j)
\]
Propiedades clave:
El número total de aristas sigue una distribución Binomial: \[
|E| \sim \text{Binomial}\left(\binom{n}{2}, p\right)
\]
El grado de cada nodo\(k_i\) también sigue una Binomial: \[
k_i \sim \text{Binomial}(n-1, p)
\]
La mayoría de los nodos tienen un grado cercano al promedio: \[
\mathbb{E}[k_i] = p(n-1)
\]
No aparecen hubs: todos los nodos tienen grados parecidos.
Es un modelo simple y controlado, ideal como referencia o “punto de comparación” para redes reales.
Redes preferenciales (Barabási–Albert)
La red de Barabási–Albert (BA) se basa en el principio de apego preferencial (preferential attachment). La idea es que los nodos nuevos prefieren conectarse con los nodos que ya son populares (los que tienen más conexiones).
Construcción:
Se inicia con un pequeño número de nodos conectados.
En cada paso, se agrega un nuevo nodo que se conecta con \(m\) nodos existentes.
La probabilidad de que el nuevo nodo se conecte con el nodo \(i\) es proporcional a su grado \(k_i\):
La red es escalafree (scale-free): no hay un grado típico, y existen nodos con muchísimas conexiones.
Describe bien muchas redes reales: Internet, redes sociales, redes biológicas, transporte, etc.
HUBS
Un hub (plural: hubs) es un nodo muy conectado dentro de una red, es decir, un vértice que tiene un grado (k_i) mucho mayor que el promedio.
En términos simples:
En una red, cada nodo tiene cierto número de conexiones o enlaces.
Si la mayoría de los nodos tienen, por ejemplo, 2 o 3 conexiones, pero algunos tienen 20 o más, esos pocos nodos altamente conectados se llaman hubs.
Ejemplo
En una red social, los usuarios “normales” pueden tener unos cientos de amigos, pero unas pocas personas (influencers, celebridades, etc.) tienen miles o millones de conexiones. Ellos son los hubs de la red.
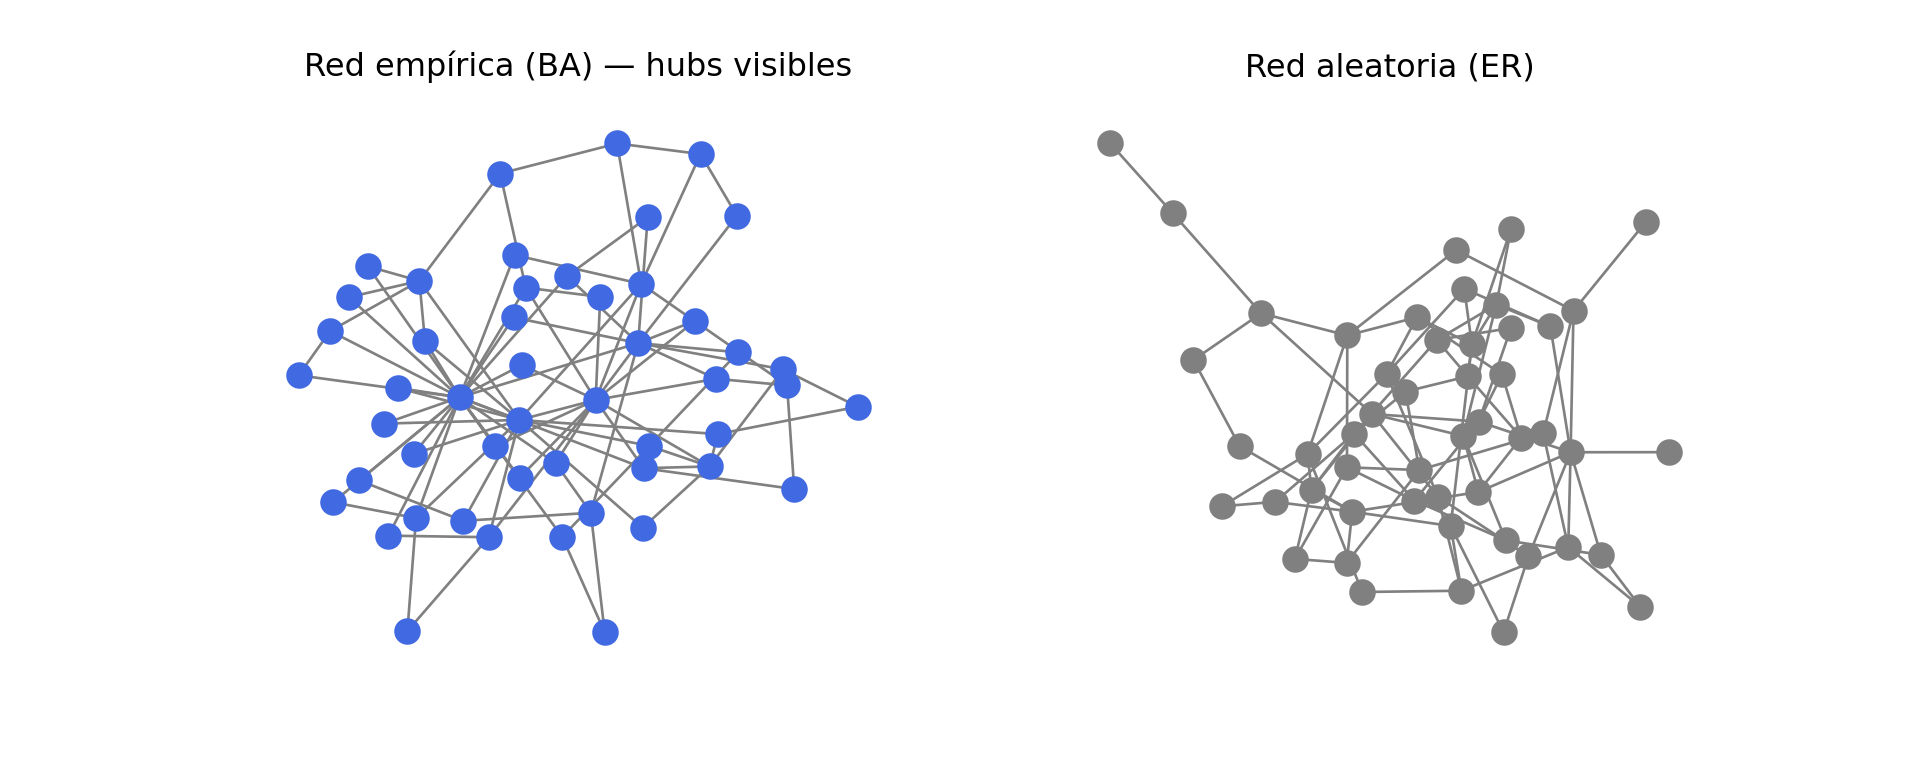
En las redes aleatorias (Erdős–Rényi) no suelen aparecer hubs: casi todos los nodos tienen grados parecidos.
En las redes preferenciales (Barabási–Albert) sí aparecen hubs, porque los nodos nuevos tienden a conectarse con los que ya tienen muchas conexiones — este fenómeno se conoce como preferencia de apego (preferential attachment).
Los hubs son nodos que concentran gran parte de las conexiones de una red y son responsables de su robustez, eficiencia y, a veces, vulnerabilidad.
Ejemplo práctico (Python, paso a paso)
Paso 0 — Preparación: importar librerías y crear una red “empírica”
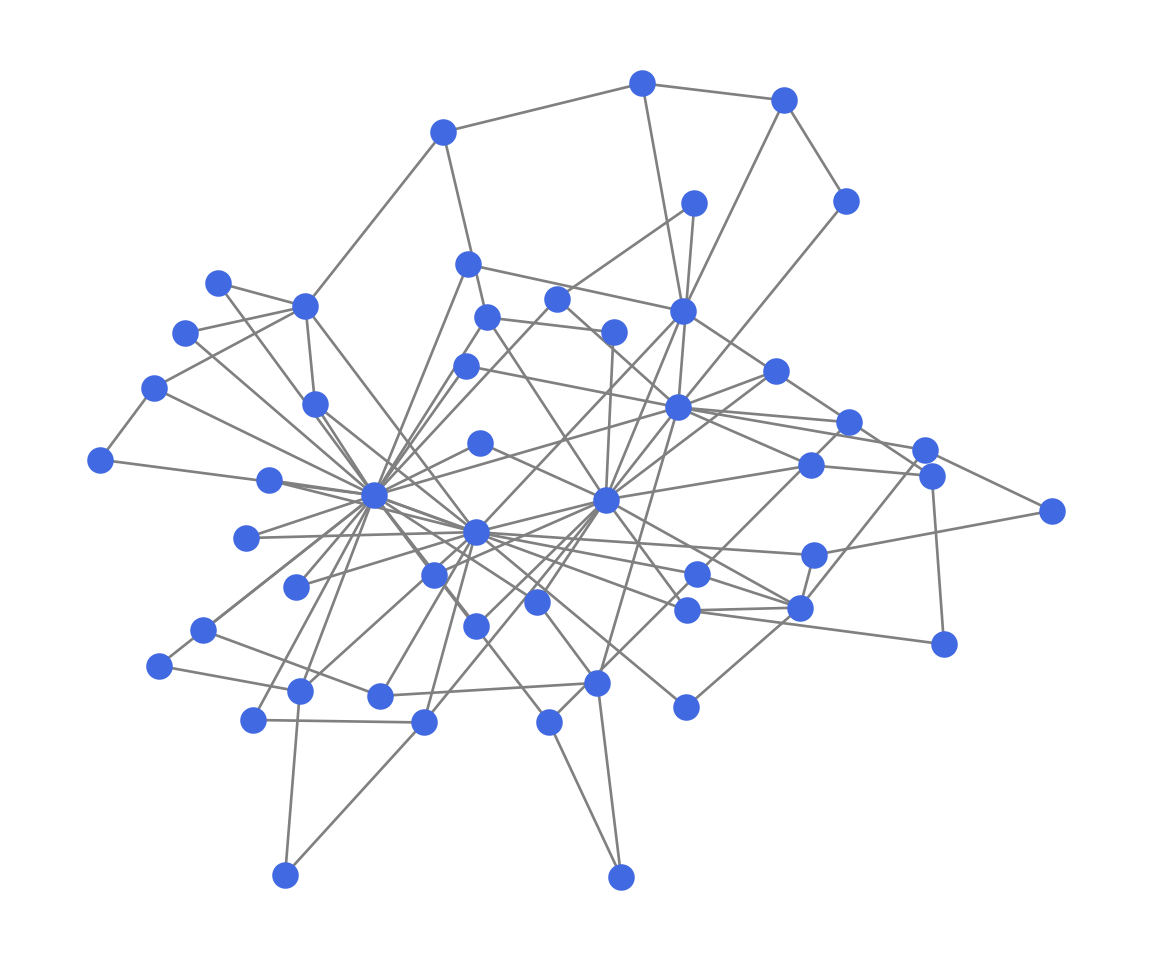
# 0) Importamos las librerías que usaremosimport networkx as nximport matplotlib.pyplot as plt# 0.1) Creamos una red "empírica" sintética: Barabási–Albert# - n=50 nodos# - Cada nuevo nodo se conecta a m=2 nodos existentes (preferencia por hubs)G = nx.barabasi_albert_graph(50, 2, seed=42)# 0.2) Mostramos la red (solo para ubicarla visualmente)# Creamos una figura de tamaño 6x5 pulgadasplt.figure(figsize=(6,5))# Dibujamos el grafo 'G' usando la disposición (layout) de tipo "spring"# El layout spring_layout simula un sistema de resortes:# - Los nodos se repelen entre sí# - Las aristas actúan como resortes que los atraen# Esto produce una representación equilibrada y legible de la red.nx.draw( G, pos=nx.spring_layout(G, seed=1), # disposición reproducible node_size=80, # tamaño de cada nodo node_color="royalblue", # color de los nodos edge_color="gray"# color de las aristas)# Agregamos un título descriptivo al gráficoplt.title("Red empírica sintética (Barabási–Albert)")# Quitamos los ejes (no son útiles en este tipo de gráficos)plt.axis("off")
# Mensaje final para confirmar que se generó correctamenteprint("Listo: tenemos una red con 50 nodos y preferencia por hubs.\n")
Listo: tenemos una red con 50 nodos y preferencia por hubs.
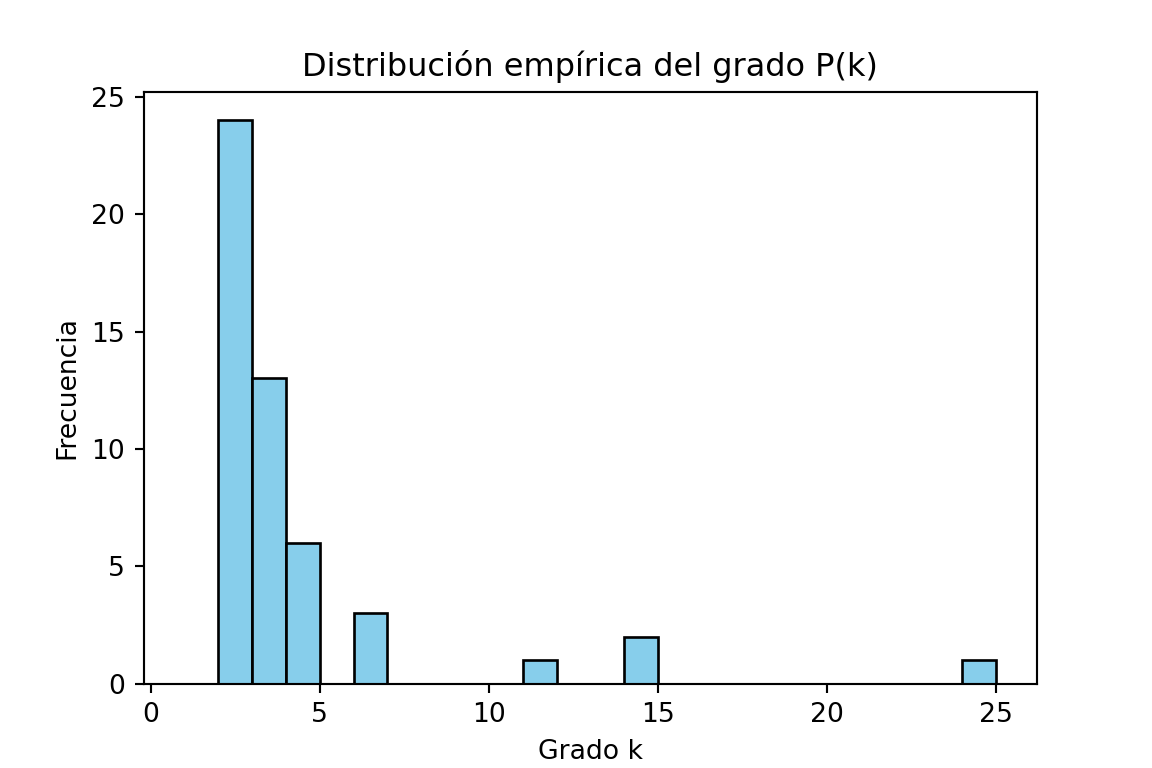
Paso 1 — Distribución de grados (P(k))
# 1) Obtenemos el grado (número de conexiones) de cada nodogrados = [d for _, d in G.degree()]print("Ejemplo de grados (primeros 10 nodos):", grados[:10])
# 1.1) Graficamos el histograma de P(k)plt.figure(figsize=(6,4))plt.hist(grados, bins=range(1, max(grados)+2), color="skyblue", edgecolor="black")plt.xlabel("Grado k")plt.ylabel("Frecuencia")plt.title("Distribución empírica del grado P(k)")plt.show()
Histograma de grados: P(k) en la red empírica
print("Interpretación: si hay cola larga (valores altos de k con cierta frecuencia), hay hubs.\n")
Interpretación: si hay cola larga (valores altos de k con cierta frecuencia), hay hubs.
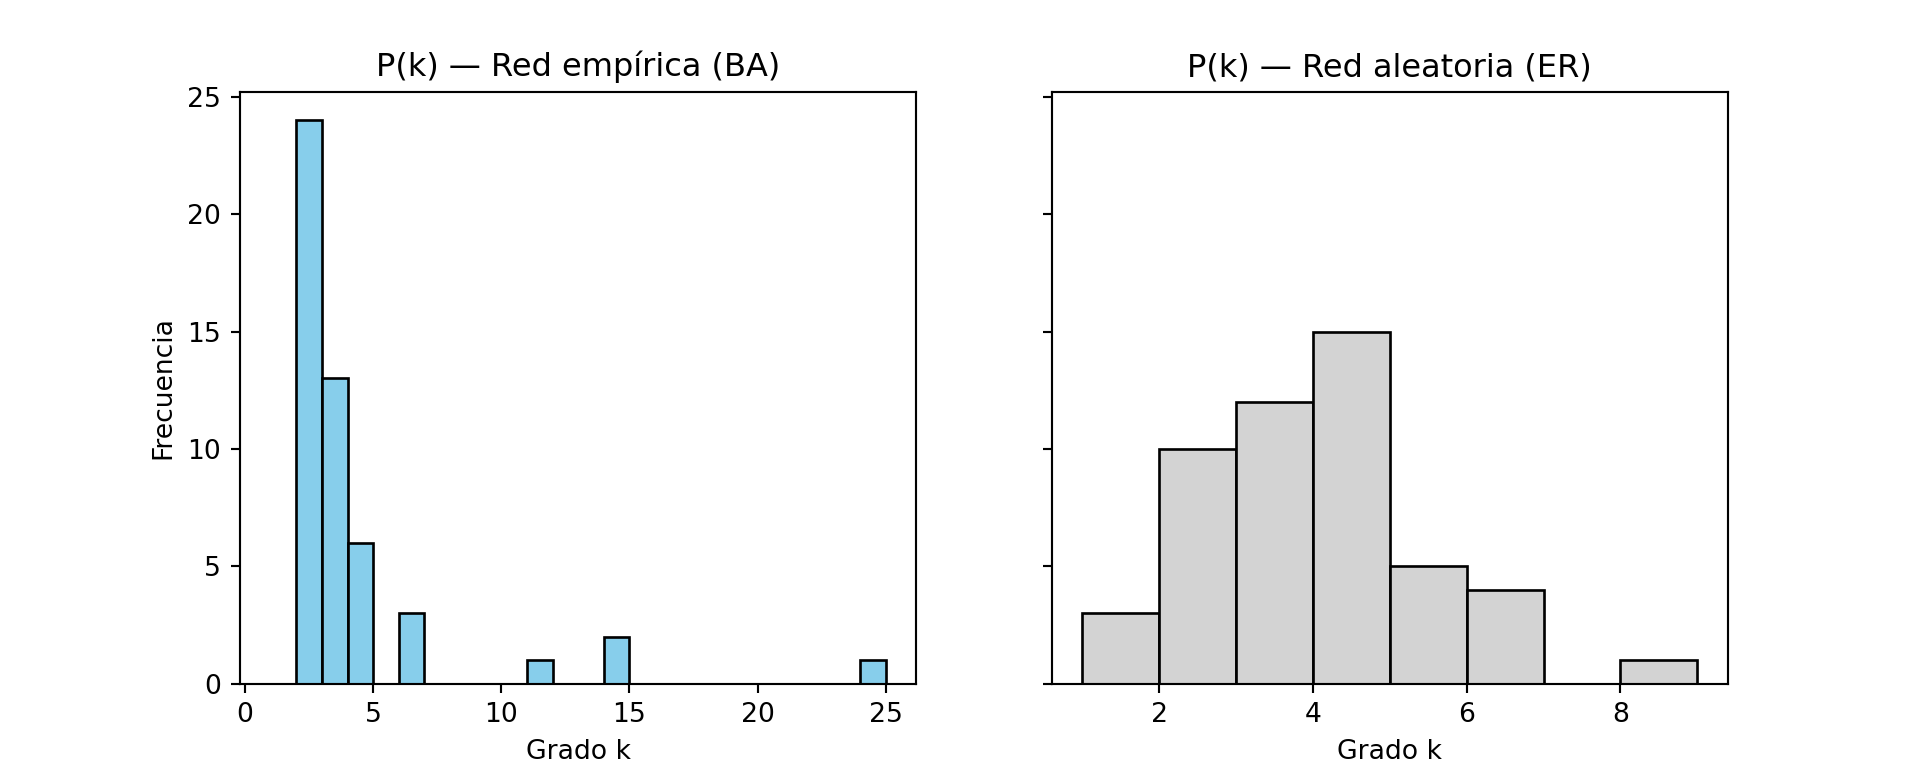
Paso 2 — Red aleatoria equivalente (Erdős–Rényi) y comparación de (P(k))
# 2) Construimos una red ER(n, p) con:n = G.number_of_nodes()m = G.number_of_edges()p =2*m / (n*(n-1)) # probabilidad media de conexión que iguala el número de aristasER = nx.erdos_renyi_graph(n, p, seed=42)# 2.1) Histogramas lado a ladogrados_ER = [d for _, d in ER.degree()]import matplotlib.pyplot as pltfig, ax = plt.subplots(1, 2, figsize=(10,4), sharey=True)ax[0].hist(grados, bins=range(1, max(grados)+2), color="skyblue", edgecolor="black")ax[0].set_title("P(k) — Red empírica (BA)")ax[0].set_xlabel("Grado k"); ax[0].set_ylabel("Frecuencia")ax[1].hist(grados_ER, bins=range(1, max(grados_ER)+2), color="lightgray", edgecolor="black")ax[1].set_title("P(k) — Red aleatoria (ER)")ax[1].set_xlabel("Grado k")plt.show()
Comparación de P(k) entre red empírica y red aleatoria ER
print("Comparación: ER tiende a P(k) más compacta (tipo binomial), BA muestra más heterogeneidad.\n")
Comparación: ER tiende a P(k) más compacta (tipo binomial), BA muestra más heterogeneidad.
Paso 3 — Visualización estructural: empírica vs. aleatoria
→ Q > 0.3: comunidades bien definidas (estructura modular fuerte).
print(" → Q muy alto (> 0.6): grupos muy densos y separados entre sí.\n")
→ Q muy alto (> 0.6): grupos muy densos y separados entre sí.
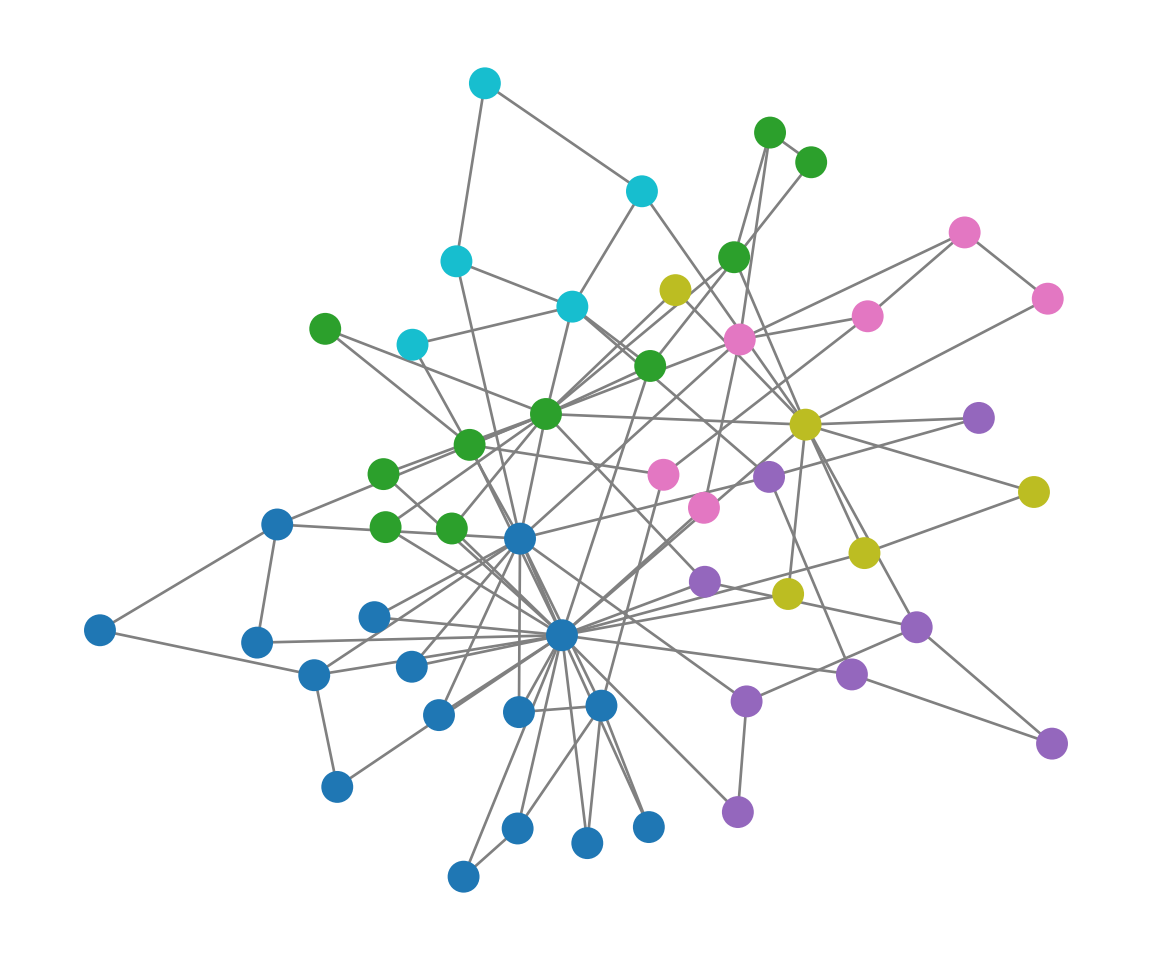
# 4.3) Asignamos color por comunidad y graficamoscolor_map = {}for i, com inenumerate(comunidades):for nodo in com: color_map[nodo] = icolores = [color_map[n] for n in G.nodes()]plt.figure(figsize=(6,5))nx.draw(G, pos=nx.spring_layout(G, seed=2), node_color=colores, cmap=plt.cm.tab10, node_size=120, edge_color="gray", with_labels=False)plt.title("Comunidades detectadas (color por grupo)")plt.axis("off")
Comunidades detectadas en la red empírica (color por grupo)
# 4.4) Conclusión breveprint("💡 Si Q es alto (≈ 0.3 o más), la red presenta una estructura modular relevante.")
💡 Si Q es alto (≈ 0.3 o más), la red presenta una estructura modular relevante.
print(" Esto significa que existen grupos de nodos más conectados entre sí que con el resto.\n")
Esto significa que existen grupos de nodos más conectados entre sí que con el resto.
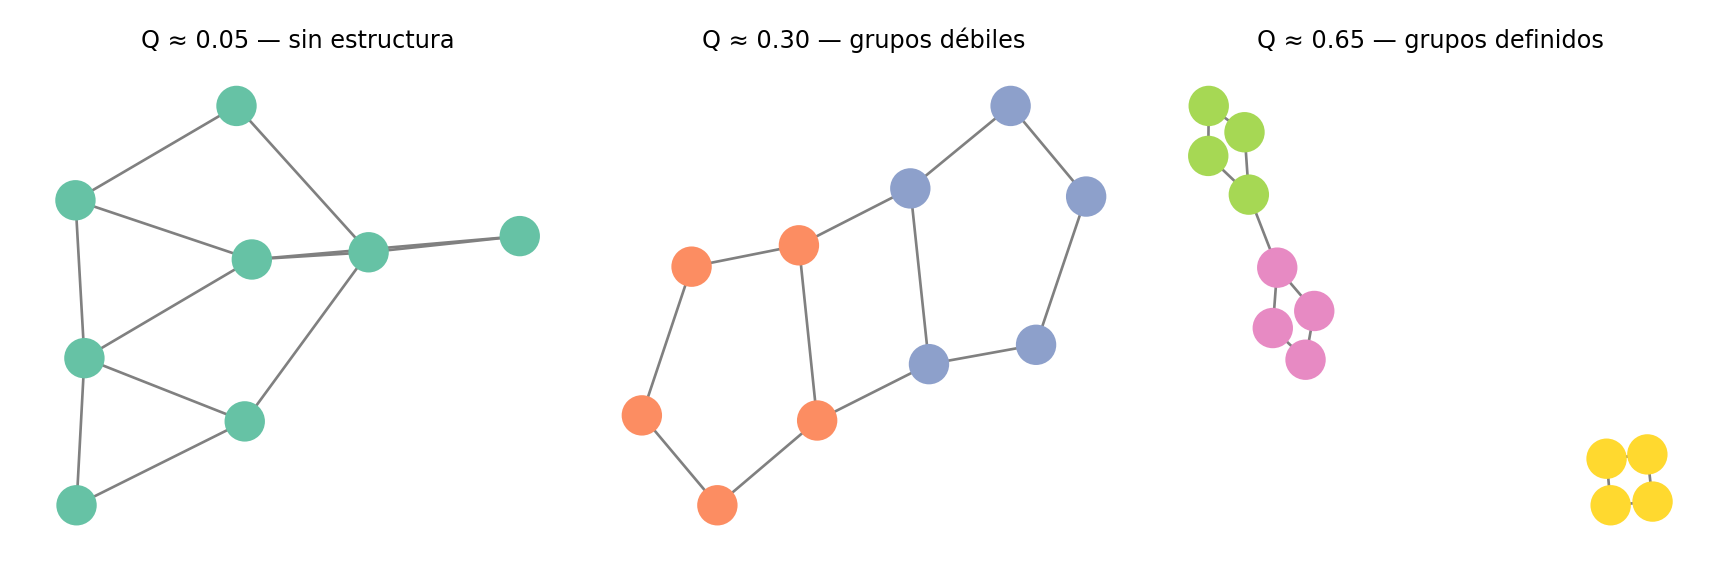
La modularidad ( Q ) es una medida que compara la densidad de enlaces dentro de las comunidades con la densidad esperada en una red aleatoria con el mismo grado de conectividad. En términos intuitivos:
Si los nodos se agrupan de manera natural —por afinidad, cercanía o interacción frecuente—, la modularidad será alta.
Si las conexiones están distribuidas al azar, la modularidad será baja o cercana a cero.
Por eso, un valor ( Q ) se interpreta como presencia de comunidades reales: hay estructuras sociales, funcionales o temáticas que segmentan la red en subgrupos internamente cohesivos. Por ejemplo:
import networkx as nximport matplotlib.pyplot as pltdef red_modularidad(tipo):"""Crea redes pequeñas con distinta estructura modular."""if tipo =="baja":# Red aleatoria, sin grupos G = nx.erdos_renyi_graph(8, 0.4, seed=1) colores = ["#66c2a5"] *8elif tipo =="media":# Dos grupos con algunos enlaces entre ellos G1 = nx.cycle_graph(5) G2 = nx.cycle_graph(5) G = nx.disjoint_union(G1, G2) G.add_edges_from([(1, 6), (2, 7)]) # pocas conexiones cruzadas colores = ["#fc8d62"] *5+ ["#8da0cb"] *5else: # Alta modularidad# Tres comunidades bien separadas G1 = nx.cycle_graph(4) G2 = nx.cycle_graph(4) G3 = nx.cycle_graph(4) G = nx.disjoint_union_all([G1, G2, G3]) G.add_edge(1, 5) # casi desconectadas colores = ["#e78ac3"] *4+ ["#a6d854"] *4+ ["#ffd92f"] *4return G, colores# --- Dibujamos tres ejemplos ---fig, axs = plt.subplots(1, 3, figsize=(9, 3))casos = ["baja", "media", "alta"]titulos = ["Q ≈ 0.05 — sin estructura","Q ≈ 0.30 — grupos débiles","Q ≈ 0.65 — grupos definidos"]for ax, tipo, titulo inzip(axs, casos, titulos): G, colores = red_modularidad(tipo) pos = nx.spring_layout(G, seed=2) nx.draw( G, pos, node_color=colores, edge_color="gray", node_size=200, with_labels=False, ax=ax ) ax.set_title(titulo, fontsize=9) ax.axis("off")