Proyecto
Sistema de Recomendación de Música con Árboles de Decisión
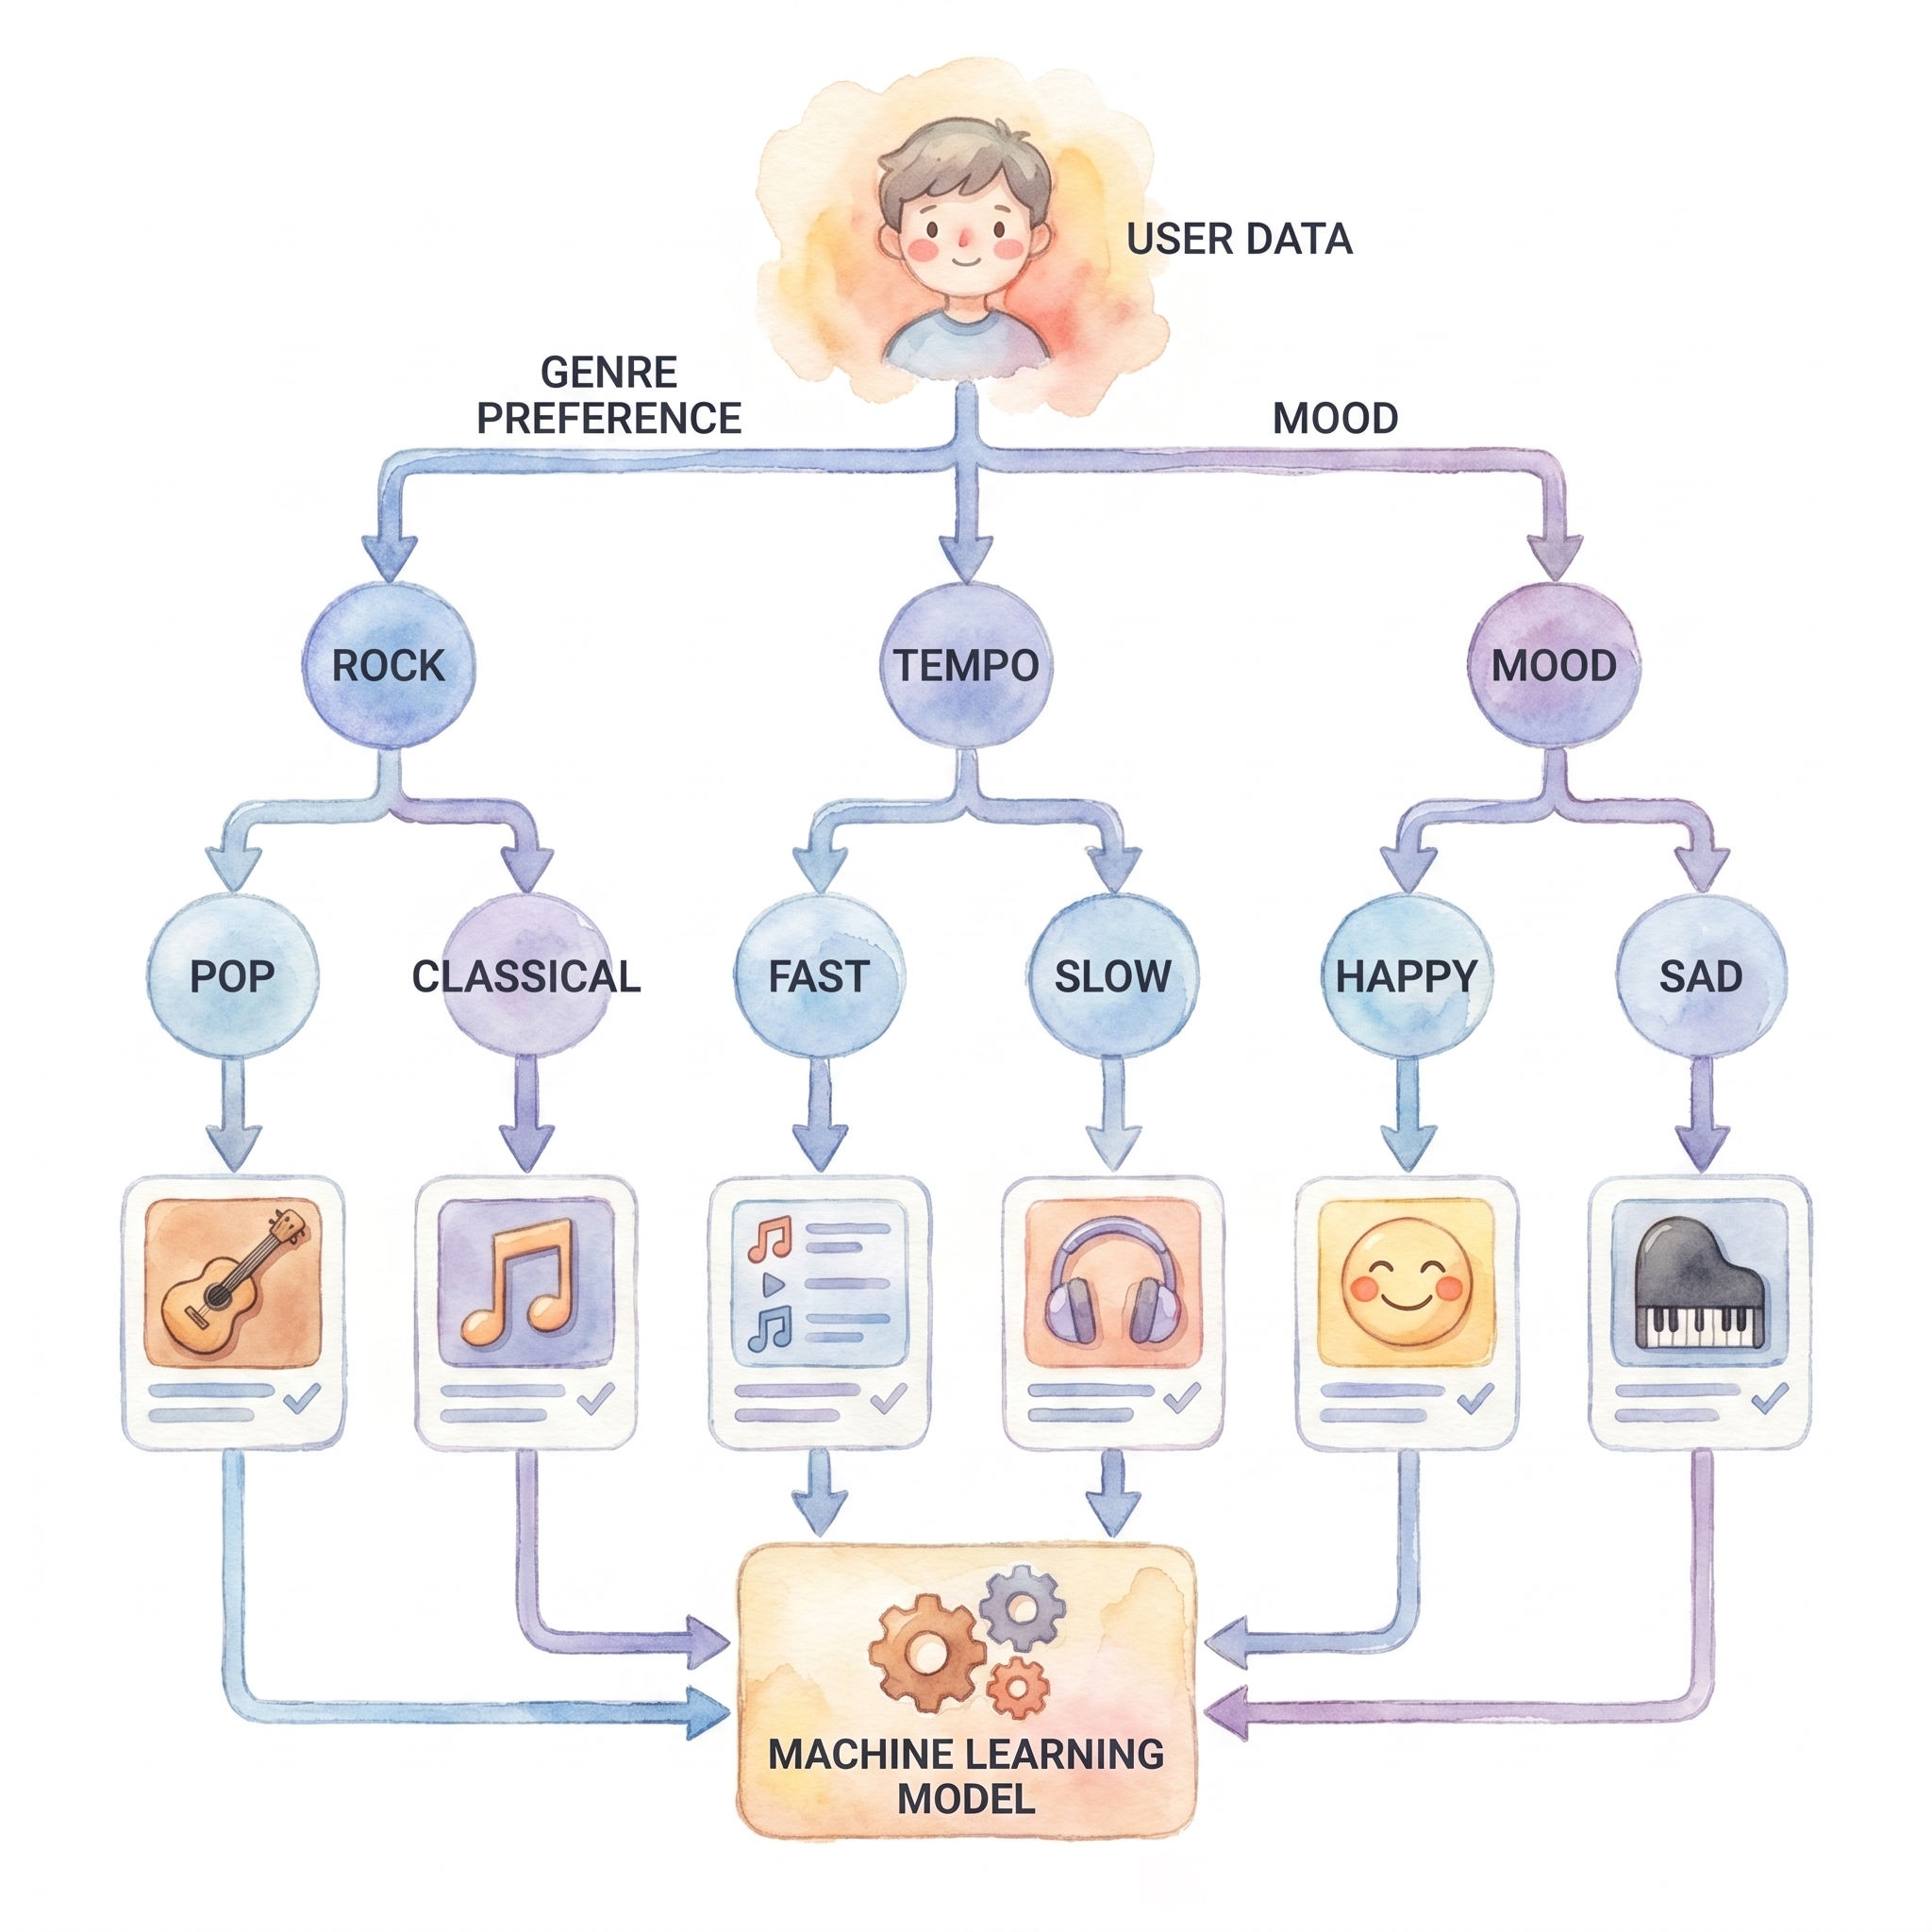
En esta clase vamos a construir un modelo sencillo que aprende a recomendar música según características como la edad y el género de la persona.
1. Importar librerías
import pandas as pd
from sklearn.tree import DecisionTreeClassifier
from sklearn import tree
import matplotlib.pyplot as plt
2. Cargar los datos
Trabajaremos con un archivo llamado music.csv.
music_data = pd.read_csv('music.csv')
music_data
Este dataset contiene variables como:
age: edadgender: género (0 = mujer, 1 = hombre)genre: tipo de música preferida
3. Separar variables
Dividimos los datos en:
- X → variables explicativas
- y → variable objetivo (lo que queremos predecir)
X = music_data.drop(columns=['genre'])
y = music_data['genre']

X.head()y.head()4. Crear y entrenar el modelo
model = DecisionTreeClassifier()
model.fit(X, y)
Aquí el modelo aprende patrones como:
“Personas jóvenes → HipHop”
“Personas mayores → Jazz”
5. Hacer predicciones
Probamos con nuevos datos:
predictions = model.predict([[21, 1], [22, 0]])
predictions
👉 Interpretación: - [21, 1] → persona de 21 años, hombre
[22, 0]→ persona de 22 años, mujer
6. Visualizar el árbol de decisión
Aquí es donde todo cobra sentido 👇
plt.figure(figsize=(12,8))
tree.plot_tree(
    model,
    feature_names=['age', 'gender'],
    class_names=model.classes_,
    filled=True
)
plt.show()
El árbol representa una serie de reglas secuenciales que el modelo utiliza para clasificar el género musical a partir de la edad y el género de la persona. La lectura siempre se hace de arriba hacia abajo, siguiendo condiciones del tipo “si… entonces…”.
En la raíz aparece la primera división:
age ≤ 30.5
Esto indica que la variable más importante para la primera decisión es la edad. El modelo separa a las personas en dos grupos: menores o iguales a 30.5 años, y mayores a esa edad.
Primer nivel
Si la persona tiene más de 30.5 años, el árbol no sigue dividiendo: llega directamente a una hoja donde:
gini = 0.0class = Classical
Esto significa que, en los datos de entrenamiento, todas las personas mayores de 30.5 años escuchaban música clásica. No hay incertidumbre en ese nodo.
Aquí ya puedes hacer una pausa en clase y decir: esto es un caso “perfecto”, pero también sospechoso, porque puede ser por pocos datos.
Rama izquierda (personas más jóvenes)
Si la edad es menor o igual a 30.5, el árbol sigue refinando la decisión con otra condición:
age ≤ 25.5
Esto divide el grupo joven en dos subgrupos: muy jóvenes y jóvenes intermedios.
Subgrupo: edad ≤ 25.5
Aquí aparece la variable gender:
gender ≤ 0.5
Recordando que:
- 0 = mujer
- 1 = hombre
Entonces:
- Si es mujer → el modelo predice Dance
- Si es hombre → el modelo predice HipHop
En ambos casos, el índice de Gini es 0, lo que indica que en los datos de entrenamiento esas combinaciones eran completamente homogéneas.
Subgrupo: 25.5 < edad ≤ 30.5
En este rango de edad, el modelo vuelve a usar el género:
- Si es mujer → predice Acoustic
- Si es hombre → predice Jazz
Nuevamente, nodos puros (gini = 0).
Qué significa el Gini?
El índice de Gini mide la “mezcla” de clases en un nodo:
- Gini = 0 → todas las observaciones son de la misma clase
- Gini alto → hay mezcla de géneros
En la raíz, el Gini es alto (0.778), lo que indica mucha variabilidad. A medida que el árbol divide, el objetivo es reducir esa incertidumbre.
Interpretación global
Este árbol está diciendo, en términos simples:
- La edad es la variable más importante
- Para personas mayores, la preferencia es clara (Classical)
- Para personas jóvenes, el género de la persona determina el tipo de música
“¿Qué pasaría si llega una persona de 27 años con un patrón distinto al dataset?”
Guardar el modelo
Una vez que el modelo ha sido entrenado, es posible conservar ese “conocimiento aprendido” para utilizarlo posteriormente sin necesidad de repetir todo el proceso de entrenamiento. Esto se logra mediante la serialización del objeto en un archivo externo.
import joblib
joblib.dump(model, 'music-recommender.joblib')
En este fragmento, la función dump del paquete joblib permite almacenar el modelo en un archivo con extensión .joblib. Dicho archivo contiene la estructura del árbol y los parámetros ajustados durante el entrenamiento.
Desde una perspectiva práctica, este procedimiento resulta fundamental por dos razones. En primer lugar, evita recomputar el modelo cada vez que se desea realizar una predicción, lo cual es especialmente relevante en contextos donde el entrenamiento puede ser costoso en tiempo o recursos. En segundo lugar, permite separar el proceso de construcción del modelo del proceso de uso, facilitando su implementación en aplicaciones reales.
Posteriormente, el modelo puede recuperarse en cualquier momento mediante:
model = joblib.load('music-recommender.joblib')De este modo, se dispone de un sistema capaz de generar predicciones de manera inmediata, replicando exactamente el comportamiento aprendido durante el entrenamiento original.
music-recommender.joblibERROR típico (esto es clave)
Mucha gente cree que con eso basta… pero no.
Si cambias:
- el orden de columnas
- los nombres
- el tipo de datos
👉 el modelo va a fallar o predecir mal.
Cómo usar el modelo después (BIEN)
En otro archivo o notebook:
import joblib

# cargar modelo
model = joblib.load('music-recommender.joblib')

# predecir
pred = model.predict([[21, 1]])
print(pred)
Regla de oro (IMPORTANTÍSIMA)
El modelo espera EXACTAMENTE esto:
[age, gender]Si haces esto:
model.predict([[1, 21]]) # ❌ mal ordenel modelo no se queja… pero predice basura 😬
Versión profesional
Mejor haces esto:
import joblib

data = {
    "age": [21],
    "gender": [1]
}

X_new = pd.DataFrame(data)

model = joblib.load('music-recommender.joblib')

pred = model.predict(X_new)
print(pred)
Esto evita errores silenciosos
Flujo completo
- Entrenar:
model.fit(X, y)- Guardar:
joblib.dump(model, 'modelo.joblib')- Cargar:
model = joblib.load('modelo.joblib')- Usar:
model.predict(nuevos_datos)¿Qué es accuracy?
Es la forma más simple de medir qué tan bien predice:
\[ \text{accuracy} = \frac{\text{predicciones correctas}}{\text{total de predicciones}} \]
Ejemplo:
- 8 bien de 10 → accuracy = 0.8
Evaluando nuestro modelo de música
Hasta ahora el modelo aprende…
pero necesitamos saber: ¿qué tan bueno es realmente?
Si evaluamos con los mismos datos:
model.fit(X, y)
model.predict(X)
El modelo hace trampa 😅
Ya vio esas respuestas
Dividir los datos (Train / Test)
import pandas as pd
from sklearn.model_selection import train_test_split

music_data = pd.read_csv('music.csv')

X = music_data.drop(columns=['genre'])
y = music_data['genre']

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2
)test_size=0.2→ 20% para probar- 80% para entrenar
from sklearn.tree import DecisionTreeClassifier

model = DecisionTreeClassifier()
model.fit(X_train, y_train)
El modelo SOLO ve los datos de entrenamiento
predictions = model.predict(X_test)
predictions
Aquí el modelo está “adivinando” sobre datos que nunca vio
Medir qué tan bueno es (accuracy):
from sklearn.metrics import accuracy_score

score = accuracy_score(y_test, predictions)
score- 1.0 → perfecto (sospechoso 😅)
- 0.8 → bastante bueno
- 0.5 → casi azar