Validación local
Sobreajuste
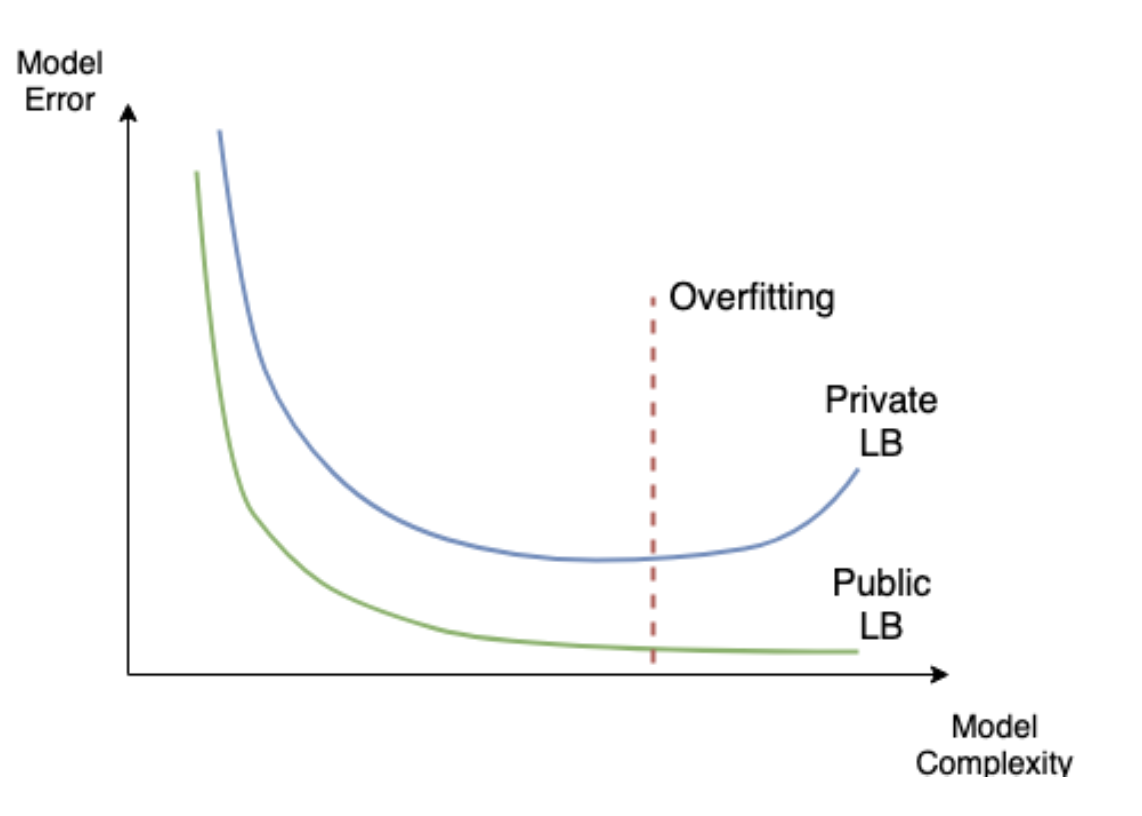
Conjunto de retención
¿Cómo aproximamos el rendimiento de los datos ocultos?
División de los datos
Todos los datos
Train y prueba
Train (70%)
Prueba (30%)
Test y retención
Train (70%)
Test (20%)
Retención (10%)
¿Para qué sirve cada parte?
Train
Se usa para que el modelo aprenda patrones a partir de los datos.
Test
Se usa para comparar modelos o ajustar decisiones.
Retención
Se guarda aparte hasta el final, para evaluar de forma más honesta.
Validación cruzada
¿Cómo usamos mejor todos los datos disponibles?
División inicial
Todos los datos
Partimos en bloques (folds)
Todos los datos
Partimos en bloques (folds)
Fold 1
Fold 2
Fold 3
Fold 4
Fold 5
Iteración 1
Test
Train
Train
Train
Train
Iteración 2
Train
Test
Train
Train
Train
Iteración 2
Train
Test
Train
Train
Train
Iteración 3
Train
Train
Test
Train
Train
Iteración 4
Train
Train
Train
Test
Train
Iteración 5
Train
Train
Train
Train
Test
Resultado final
Fold 1
Fold 2
Fold 3
Fold 4
Fold 5
Promediamos los resultados
Score final = promedio de las evaluaciones
Promediamos los resultados
\[ \text{Score final} = \frac{Score_1 + Score_2 + Score_3 + Score_4 + Score_5}{5} \]
Idea clave
Cada observación fue usada:
- para entrenar varias veces
- para evaluar exactamente una vez
Esto produce una estimación más estable del desempeño del modelo.
Validación cruzada (K-fold)
Validación cruzada (K-fold)
K-fold estratificado
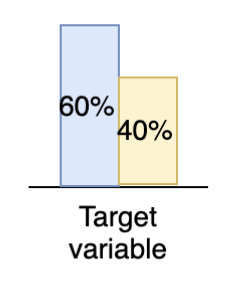
¿Y si las clases están desbalanceadas?
Problema
Train
K-fold clásico
Fold 1
Fold 2
Fold 3
Fold 4
Problema del K-fold clásico
Algunos folds pueden quedar desbalanceados.
Un fold podría tener casi todos los datos de una sola clase.
K-fold estratificado
Fold 1
Fold 2
Fold 3
Fold 4
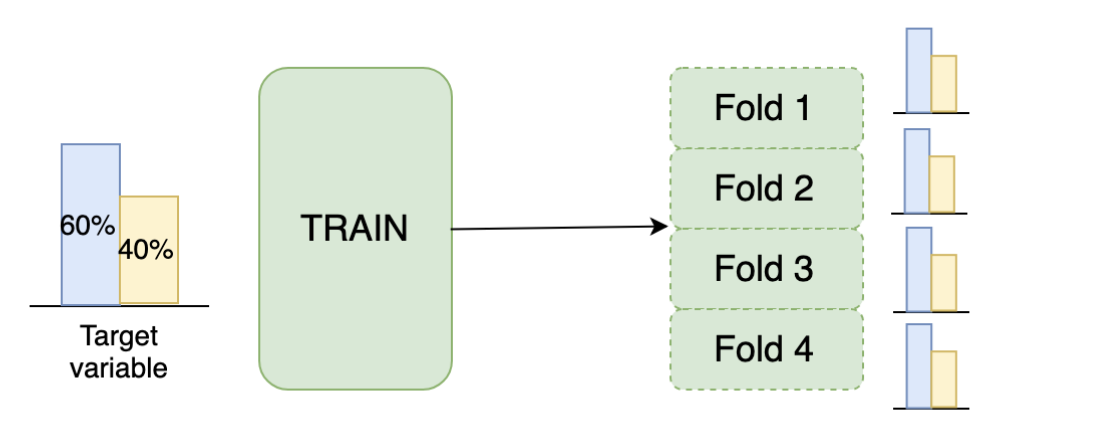
Idea clave
Cada fold mantiene la proporción de clases.
Si el dataset tiene 60% / 40%, cada fold también.
¿Cuándo usarlo?
En problemas de clasificación.
Especialmente cuando hay desbalance de clases.
K-fold estratificado en Python
# Importar la herramienta
from sklearn.model_selection import StratifiedKFold

# Crear el objeto de validación cruzada
str_kf = StratifiedKFold(
    n_splits=5,
    shuffle=True,
    random_state=123
)

# Iterar sobre los folds
for train_index, test_index in str_kf.split(train, train['target']):

    cv_train = train.iloc[train_index]
    cv_test  = train.iloc[test_index]
KFold vs StratifiedKFold
Idea clave
- KFold → puede desbalancear los folds
- StratifiedKFold → mantiene la estructura del problema