Análisis exploratorio inicial
Análisis exploratorio inicial (EDA Exploratory Data Analysis)
Objetivos del EDA
- Tamaño de los datos
- Propiedades de la variable objetivo
- Propiedades de las variables explicativas
- Generar ideas para ingeniería de variables
Ejemplo del problema
- Problema: predecir popularidad
- Variable objetivo:
interest_level
- Tipo: clasificación con 3 clases
- Métrica: log loss
EDA. Parte I
EDA. Parte I
twosigma_train = pd.read_csv('twosigma_train.csv')
print('Tamaño train:', twosigma_train.shape)

twosigma_test = pd.read_csv('twosigma_test.csv')
print('Tamaño test:', twosigma_test.shape)Test tiene todas menos la variable objetivo.
EDA. Parte I
print(twosigma_train.columns.tolist())

['id' , 'bathrooms' , 'bedrooms'
,'building_id' ,'latitude', 'longitude','manager
_ id', 'price' , 'interest _ level']
Muestra todas las columnas
EDA. Parte I
EDA. Parte I
Luego, por ejemplo, podríamos obtener la distribución de ‘interest_level’ usando el método value_counts() de
EDA. Parte I
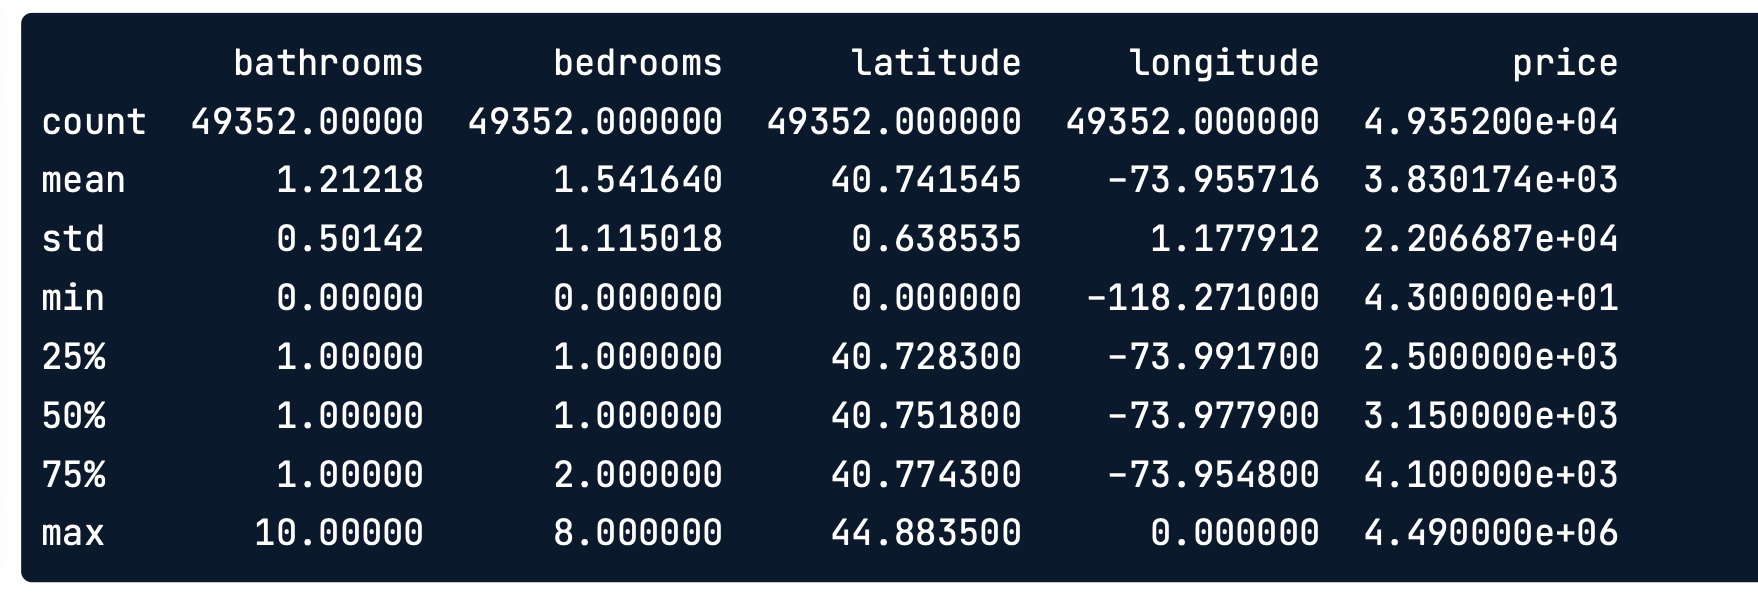
EDA. Parte II
EDA. Parte II
Resultado
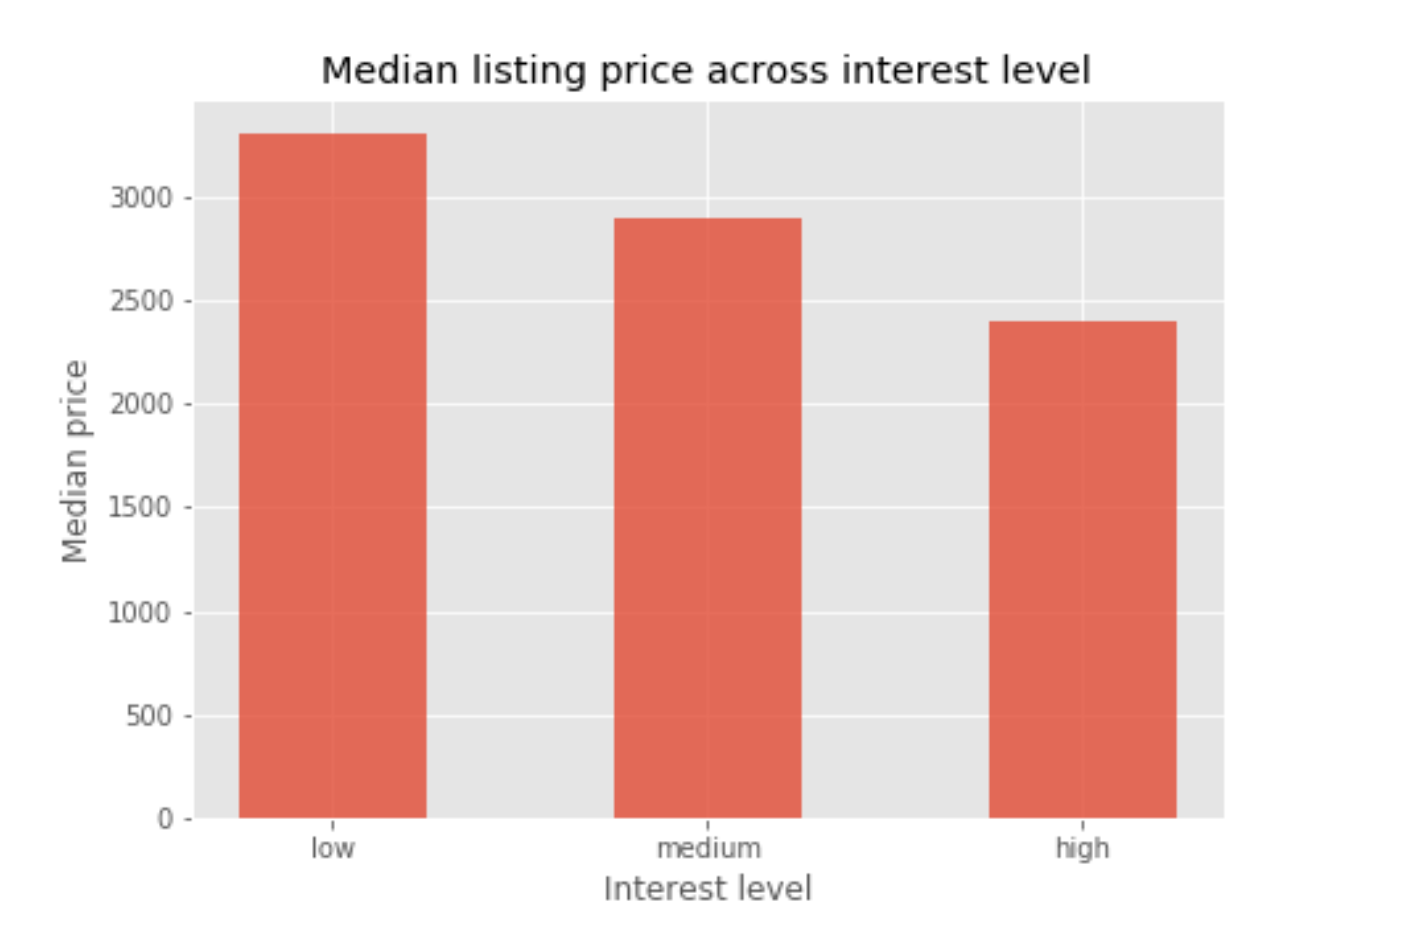
La gente busca precios mas baratos.