En Kaggle, la métrica de evaluación depende del tipo de problema.
No todas las competencias se evalúan igual, y por eso antes de modelar hay que entender qué está optimizando la competencia.
| Evaluation metric | Type of problem |
|---|---|
| Area Under the ROC (AUC) | Classification |
| F1 Score (F1) | Classification |
| Mean Log Loss (LogLoss) | Classification |
| Mean Absolute Error (MAE) | Regression |
| Mean Squared Error (MSE) | Regression |
| Mean Average Precision at K (MAPK, MAP@K) | Ranking |
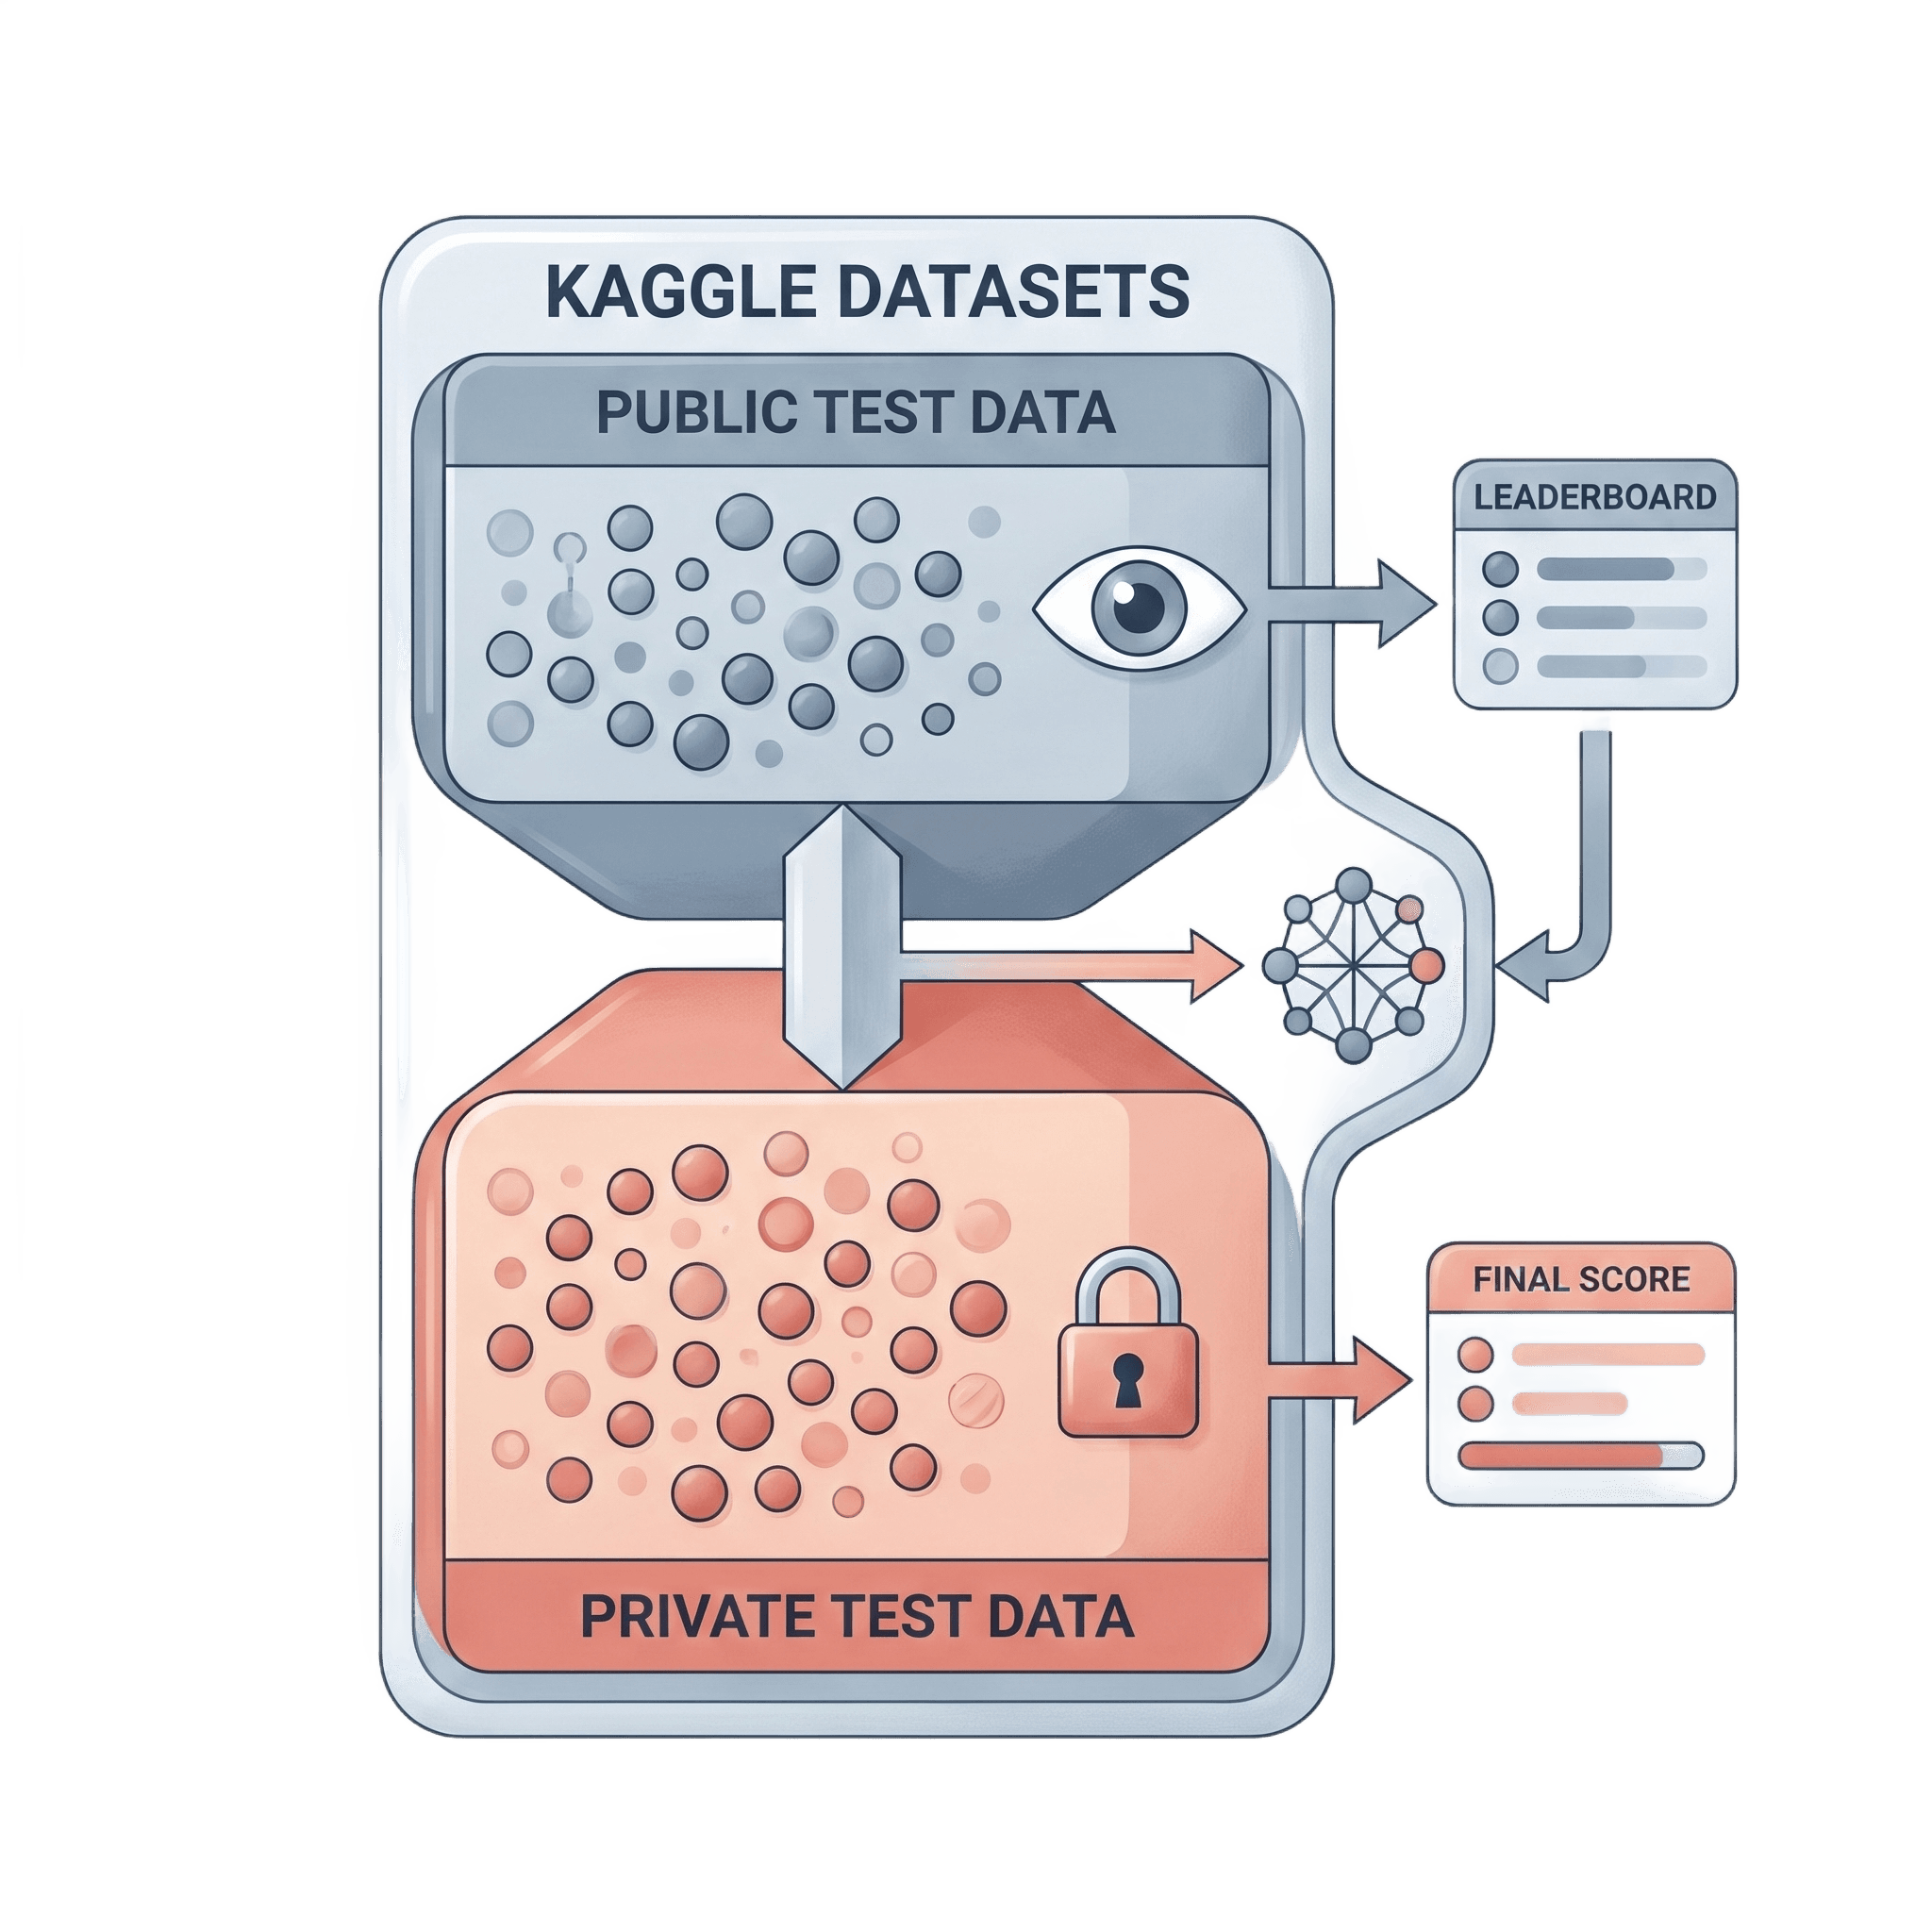
Cuando enviamos un archivo a Kaggle, ese archivo no se evalúa sobre un solo conjunto oculto.
Normalmente, la evaluación se divide en una parte pública y una parte privada.
La parte pública alimenta el public leaderboard.
La parte privada se usa al final para determinar la clasificación real.
Después de generar predicciones, el siguiente paso es guardar el archivo de envío con el formato que exige la competencia.
# Guardar el archivo de submission en disco
submission[['id', 'target']].to_csv('submission_1.csv', index=False)Ese archivo se sube a Kaggle y aparece reflejado en el leaderboard público.
| Submission | Public LB MSE | Private LB MSE |
|---|---|---|
| submission_1.csv | 2.895 | ? |
Un modelo puede verse muy bien en entrenamiento y aun así generalizar mal.
Eso es precisamente lo que queremos evitar en competencias.
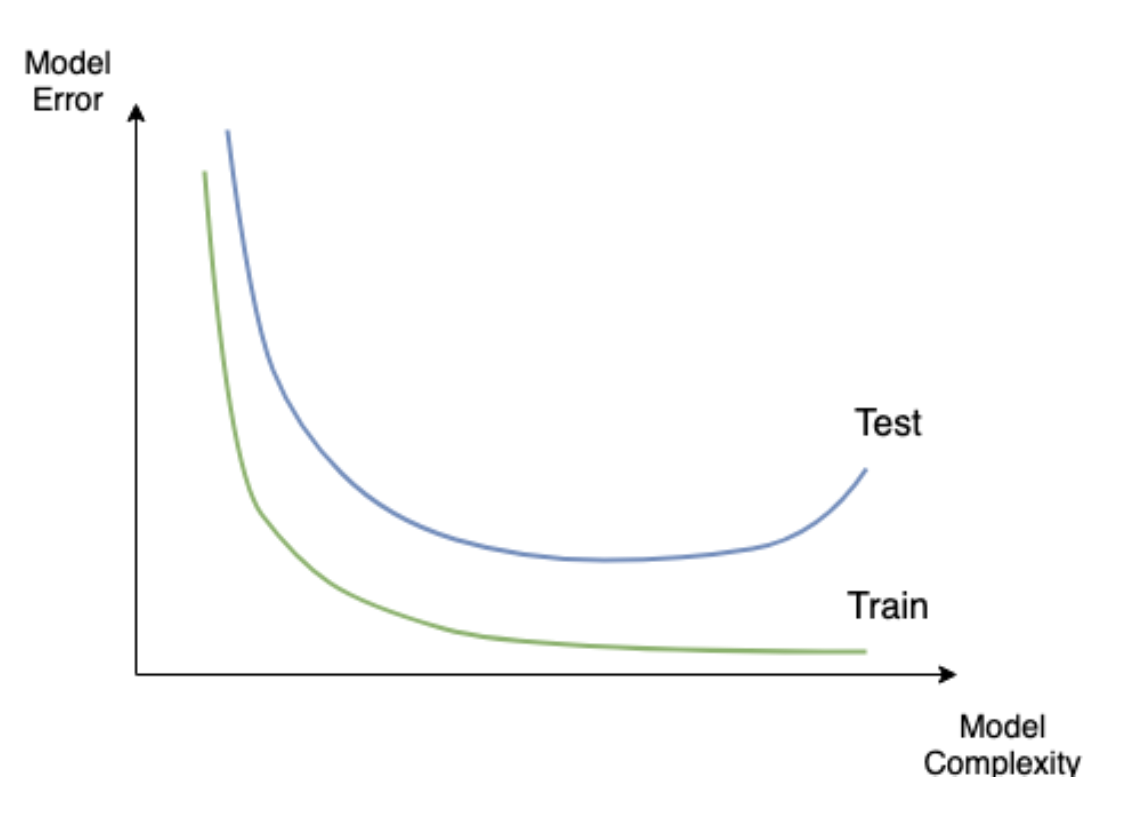
A medida que aumenta la complejidad del modelo, el error de entrenamiento suele bajar,
pero el error de prueba no necesariamente mejora.
Llega un punto en el que seguir haciendo más complejo el modelo ya no ayuda.
Desde ahí, el modelo empieza a ajustarse demasiado a los datos de entrenamiento.
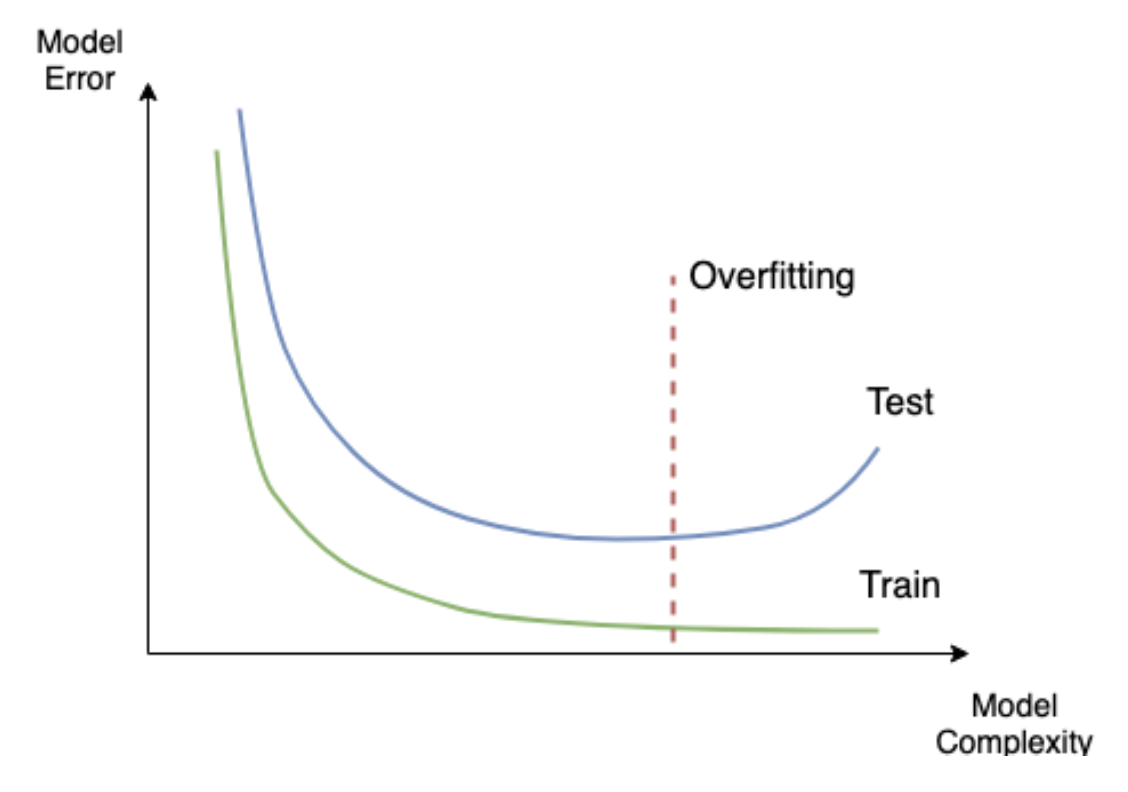
Ese punto marca el inicio del overfitting.
En Kaggle esto tiene una consecuencia muy concreta:
podemos subir en el leaderboard público y, sin embargo, caer cuando aparece el leaderboard privado.
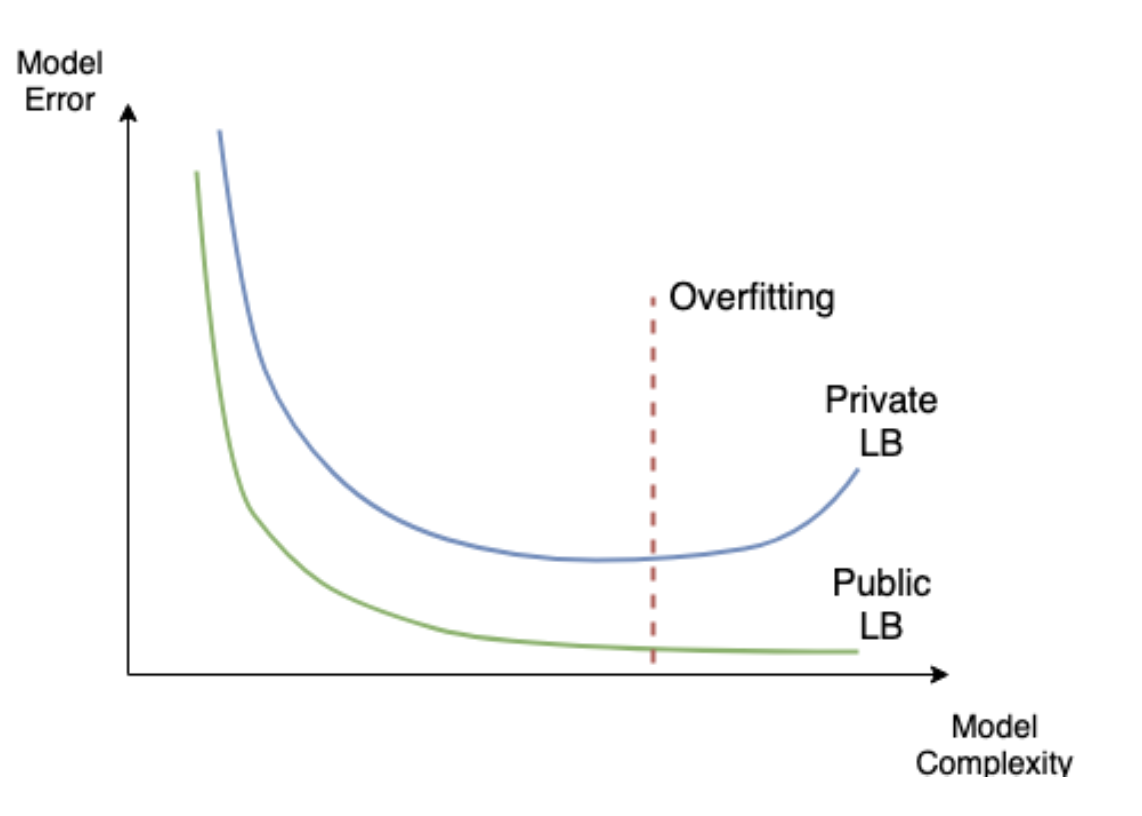
El modelo parece rendir bien en la parte pública, pero falla al evaluarse en la parte privada.
Por eso en Kaggle no basta con “subir en el ranking”.
Lo importante es construir modelos que generalicen bien, no modelos que solo funcionen para el leaderboard público.
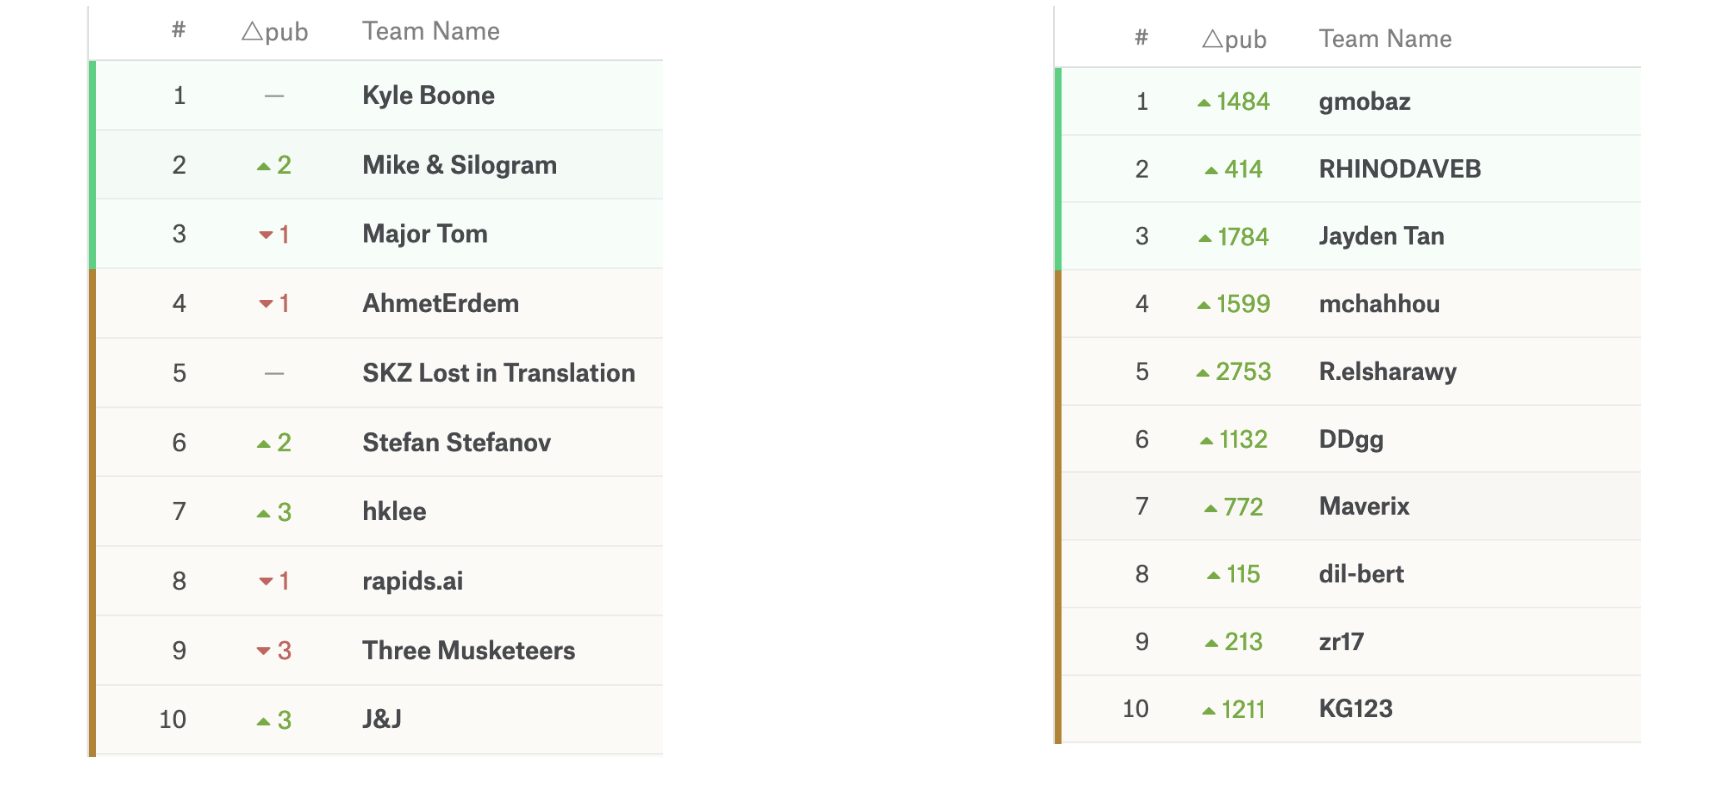
Un cambio fuerte entre ambos rankings suele indicar que muchos modelos estaban sobreajustados.
En una competencia de Kaggle, la meta no es solo obtener un buen puntaje momentáneo.
La meta real es construir un modelo que funcione bien en datos no vistos.
Métrica correcta + buen esquema de validación + control del overfitting
= una competencia mejor jugada.